背景與問題 Anthropic 最近公開說明,其單一程式碼庫(monorepo,即將多個專案的程式碼集中在同一個版本控制庫中)已從 Git 遷移至一套名為 Scion 的原始碼管控系統。這個決定源於開發規模的快速成長。根據該公司 10 月 13 日的工程文章,每日合併的變更從 5 月的約 2,500 筆,上升到 9 月的超過 30,000 筆。其持續整合(CI,Continuous Integration,自動化建置與測試程式碼變更的流程)系統每天約要進行 2,500 萬次程式碼簽出。這個單一程式碼庫的主分支歷史紀錄接近 100 GB,壓縮後的工作副本超過 25 GB。為了應對規模,Anthropic 此前採用了淺層複製(shallow clone,只下載最近的歷史紀錄)、稀疏簽出(sparse checkout,只取出部分目錄)、承諾遠端(promisor remote,延後下載特定物件)、程式碼庫快照與數百個 Git 鏡像,但隨著合併頻率提升,這些做法變得越來越難以維護。
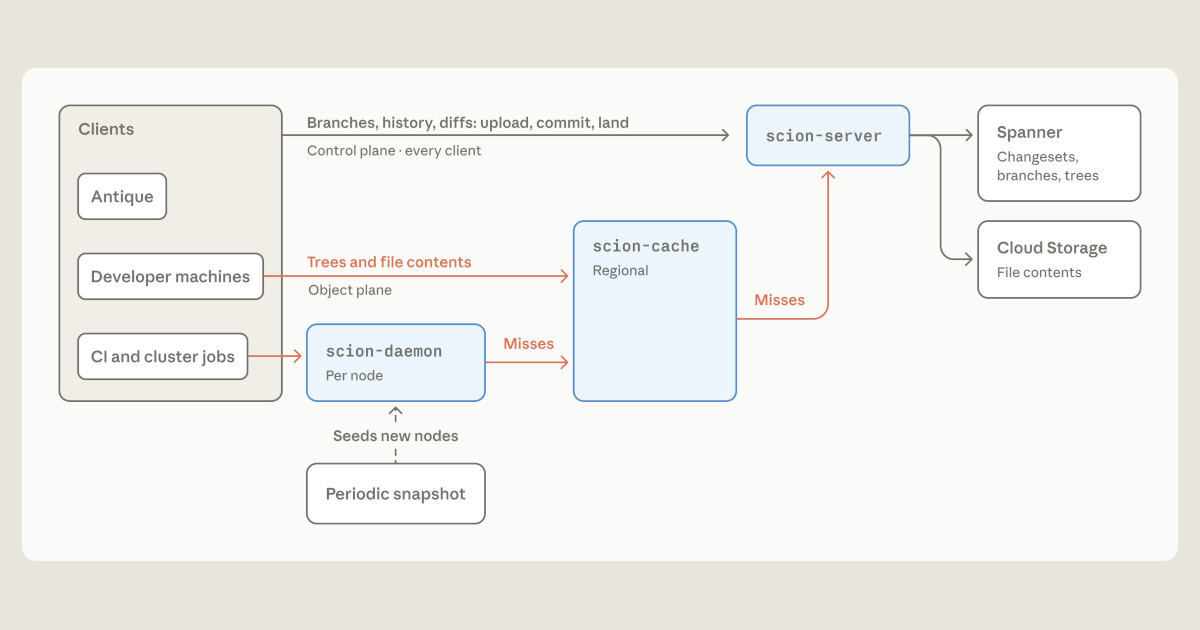
核心設計與運作方式 Scion 的核心思路是將原本在開發者電腦上執行的版本控制工作,移到伺服器端完成。提交(commit)、合併(merge)、變基(rebase)、歷史查詢與歸責查詢(blame query,找出哪一行程式碼是誰、何時修改的)全部由伺服器處理。客戶端只維護有界的物件快取,而虛擬化簽出(virtualized checkout)會在需要時才將檔案實體化。開發工具可以透過 API 查詢差異,甚至執行某些寫入操作,而不需要先簽出程式碼。
在資料模型上,Scion 的變更集(changeset)記錄相對於第一個父節點變更了哪些檔案,並以內容定址儲存(content-addressed storage,根據內容雜湊值儲存與定位資料)的指標,指向儲存在物件儲存空間中的壓縮檔案內容。建立變更集與更新參照(reference,指向特定提交的名稱或指標)是分開的動作,因此接受變更集不需要跨伺服器協調。為了支援歷史與歸責查詢,伺服器會建立稱為「衍生資料」(derived data,從既有變更集遞迴計算出的輔助索引結構)的額外結構,可以預先計算或視需求即時產生。因為這些計算都在伺服器端進行,衍生資料可以演進而不需要修改客戶端。
簽出程式碼時,客戶端直接請求遺失的不可變樹狀結構(tree)與二進位大型物件(blob,二進位資料物件),不再與伺服器協商自訂的封裝檔案(packfile)。每個節點上的本端守護程式(daemon,背景執行的處理程序)在作業之間共享快取物件,若未命中則向區域快取索取,區域快取再向權威伺服器索取。權威伺服器由 Spanner 與雲端儲存空間支援。各層級快取暴露相同的簽出協議遠端程序呼叫(RPC,一種讓程式能像呼叫本地函式一樣使用伺服器服務的機制),但 Anthropic 強制執行其呼叫順序,以隔離故障,避免區域快取故障壓垮權威伺服器。稀疏與虛擬化簽出只請求真正需要的物件。
效能與基礎設施影響 Anthropic 報告指出,每層快取的命中率(cache-hit rate,快取命中比例)超過 99%,與之前數百個 Git 鏡像相比,CPU 與記憶體基礎設施佔用縮小了 200 倍,CI 與研究作業的簽出速度提升了兩個數量級。這些數字來自公司內部工作負載,並非針對 Git 的通用基準測試。
Scion 的設計也參考了既有研究。Anthropic 在 10 月 15 日的更新中明確指出,Mononoke 及其 Bonsai 資料模型開創了許多採用的技術。與 Uber 之前將標準 Git 操作集中化的 GitFarm 不同,GitFarm 並未取代原始碼管控系統本身,Scion 則更進一步,直接改變了底層資料模型。
適用範圍與限制 儘管效能顯著,Anthropic 強調 Scion 並非通用的 Git 替代方案。它需要搭配自有的程式碼審查、程式碼搜尋與 CI 系統,且實作高度客製化。對於大多數組織,較現實的做法是將 Scion 的部分理念,例如完整的伺服器端 API 與改進的擷取協議,引入現有的 Git 平台。
對於架構師而言,關鍵啟示在於隨工作負載變化,重新思考工作應該發生在哪裡。程式碼庫查詢不一定需要本端簽出,不可變物件可以透過快取共享,這樣可以減少重複工作。但 Scion 依賴伺服器可用性,犧牲了離線獨立性,並且所需的整合工程量非常大。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。