背景與發布
根據 OpenAI 在 2026 年 11 月 17 日於 openai.com 發布的說明,更新版 Astra for Law 已開始提供更多企業客戶使用。這項產品不是一個獨立的全新模型,而是一種模型配置。它把 GPT-6.2 Astra 與擴充後的法律搜尋索引,以及一組針對法律研究的指令結合在一起;前者是 OpenAI 所稱最新、能力最強的前沿模型,也就是處於現階段能力水準的大型模型,後者則用來引導模型查找問題相關資料、衡量權威依據,並把答案寫成可供法律工作使用的論述。
從當天起,所有 ChatGPT Enterprise 客戶都能透過 Trusted Access Program 提出存取申請;這套機制是 OpenAI 讓企業在受控範圍內取得特定模型或功能的方式。已取得存取權的團隊可在 ChatGPT 中選擇 gpt-6.2-astra-law。官方也開放透過 API 申請,API 是應用程式介面,可讓企業把模型能力接進自有工具與工作流程。
模型配置的核心
法律工作對 AI 的要求不只是流暢回答,而是能否找到正確依據、處理相互衝突的權威見解,並把結論寫成能被律師檢視的論證。OpenAI 在 9 月先將 Astra for Law 提供給少數律師事務所試用,包括 Cooley、Ropes & Gray 與 Sullivan & Cromwell。其後,研究團隊改良法律推理,並把法律搜尋索引擴大 34%,新增逾 8,000 萬個網址,覆蓋英國、澳洲、加拿大等司法管轄區。目前索引超過 3.1 億個網址,並涵蓋逾 99.9% 已發布且具先例效力的美國判例法。對律師而言,索引範圍不只是資料量問題,而是能否找到法院曾經怎麼判斷、哪個見解仍具說服力,以及答案能否被追溯到具體來源。
基準結果與幻覺控制
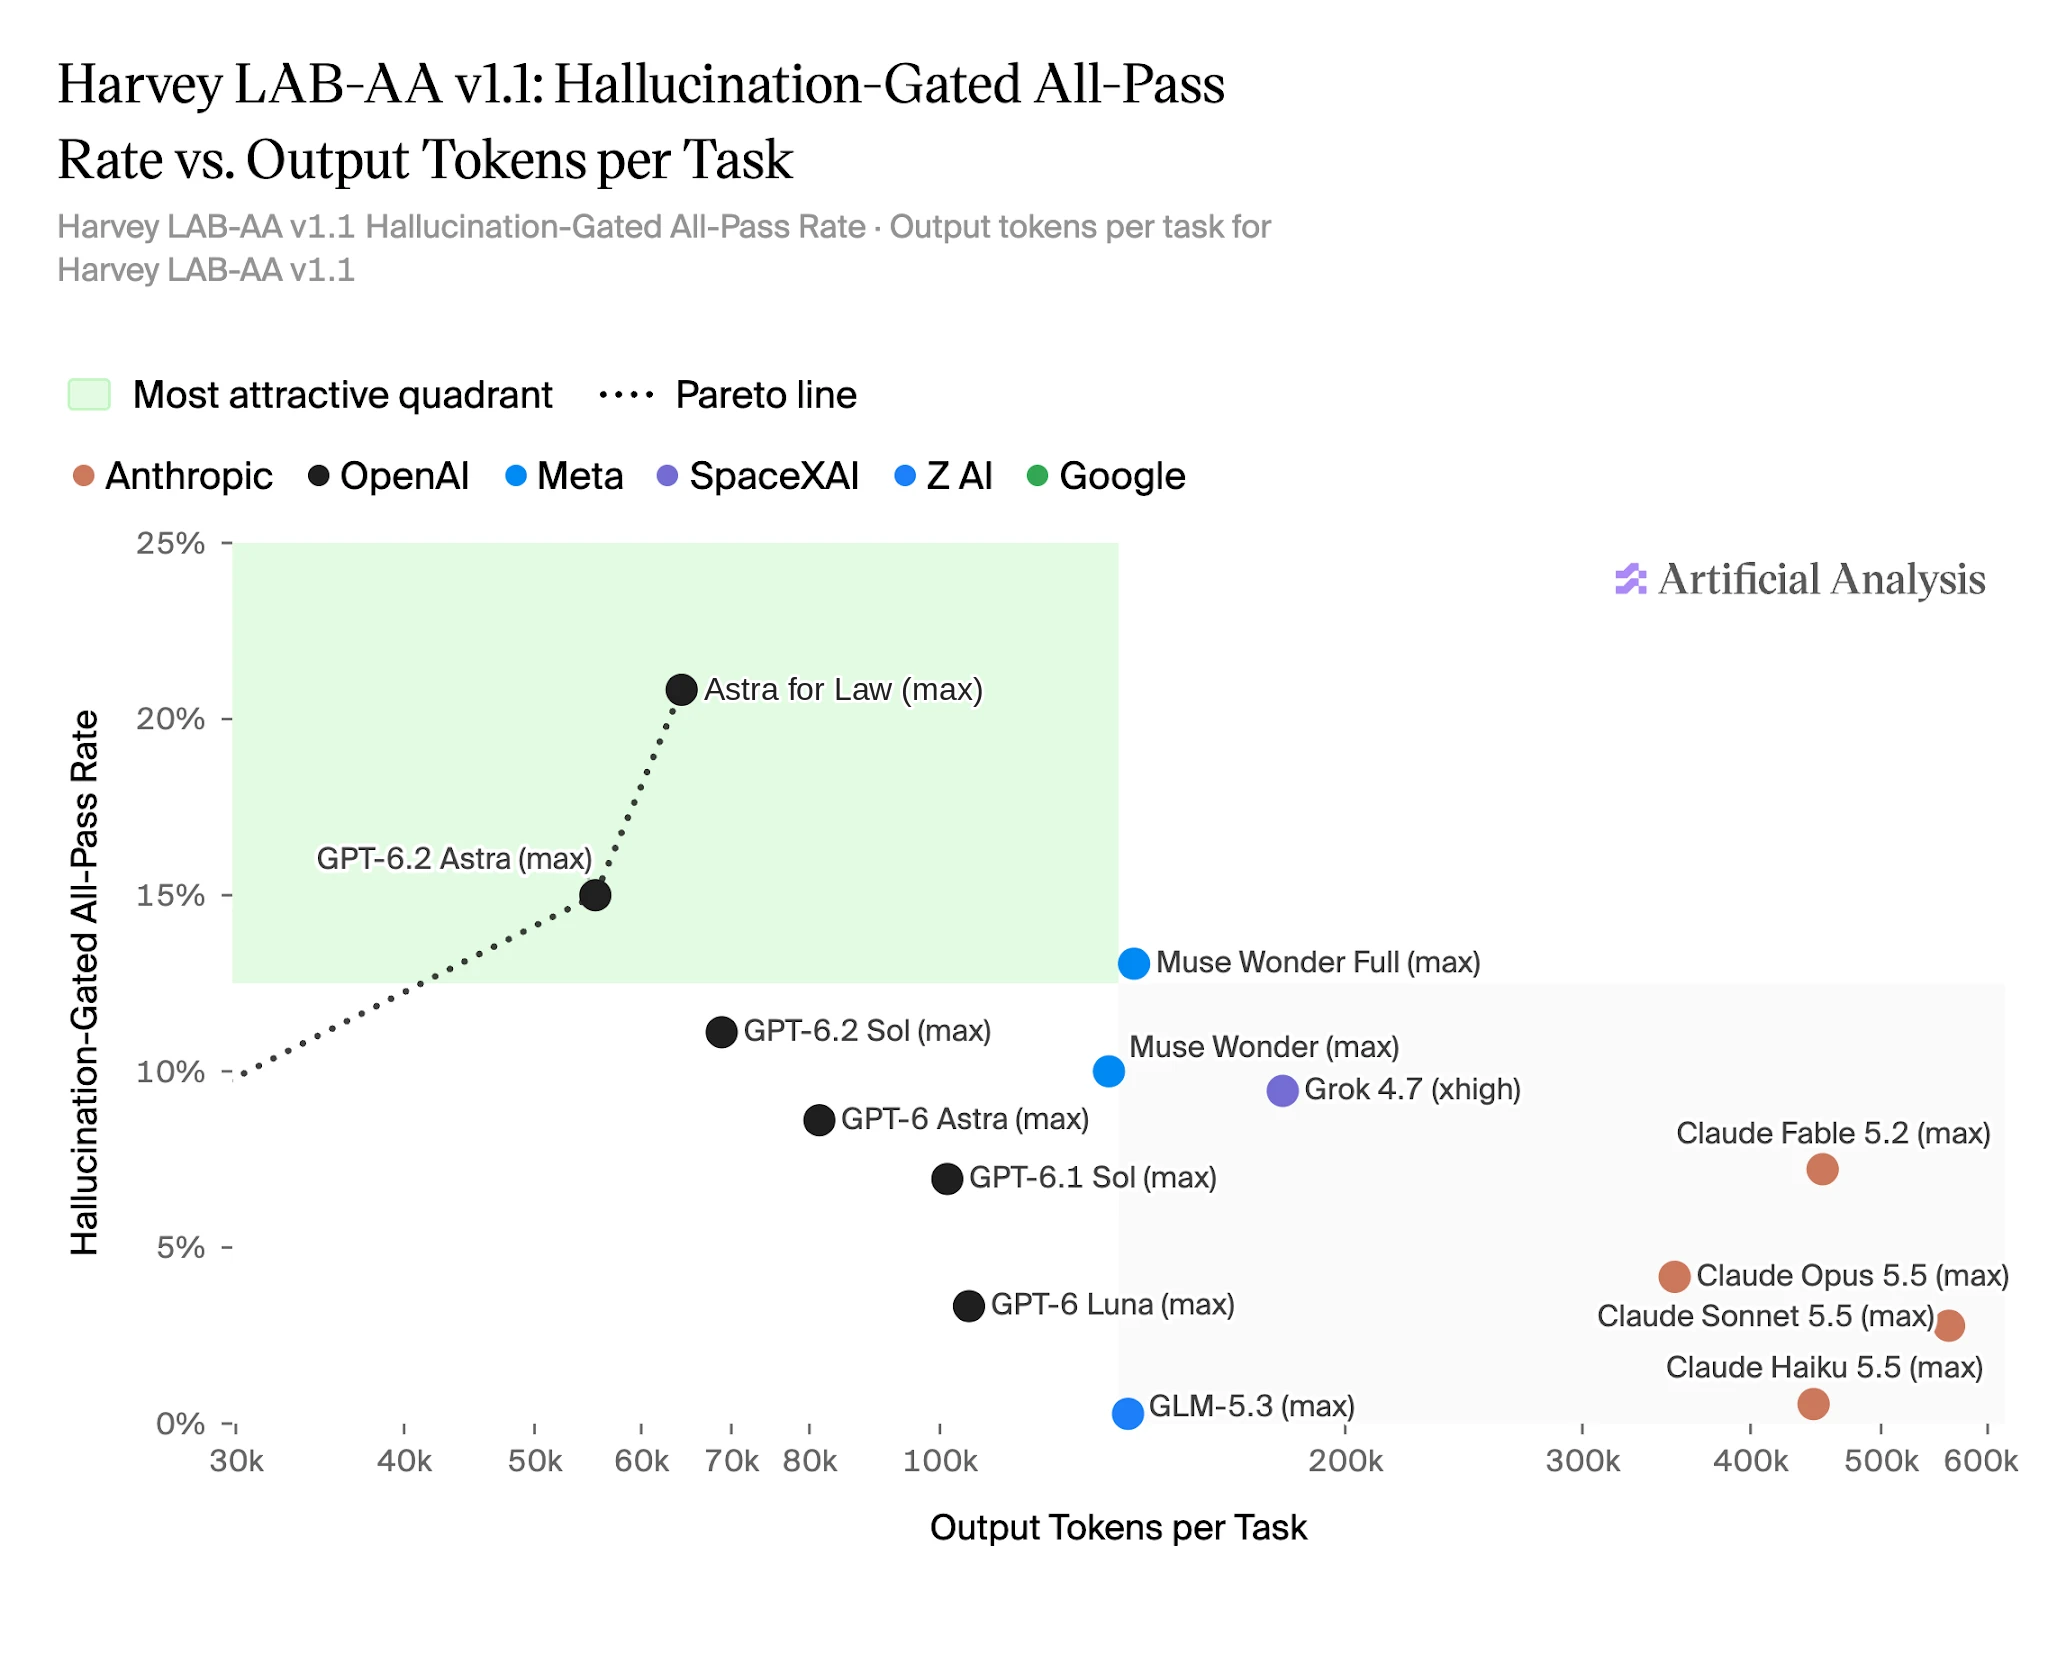
Harvey 的 Legal Agent Benchmark 用來測試模型能否從頭到尾完成法律任務,LAB-AA 則是 Artificial Analysis 製作的評測版本, purpose 在於以外部標準檢視同一類能力。它包含 120 項作業,分布在 24 個法律領域,從起草證人訊問大綱、審查商業租賃,到規劃收購中的所有權變動。要拿到滿分,答案必須滿足作業每一項要求,且不能出現幻覺;幻覺在法律脈絡中,是指提出沒有來源文件支持的實質主張。
OpenAI 公布的結果顯示,Astra for Law 在 20.8% 作業取得滿分,排名第一;GPT-6.2 Astra 為 15.0%,Muse Wonder Full 為 13.1%。這代表 Astra for Law 較基礎模型高出近四成,也較得分最高的非 OpenAI 模型 Muse Wonder Full 高約 59%。另一個指標是輸出 token 數量,也就是模型在推理與寫作時產生的文字單位;Astra for Law 平均每項作業約 64,000 個 token,Muse Wonder Full 則約 139,000 個,相差 54%。在按用量計費的企業環境裡,這項差距會直接影響成本控管。官方也指出,在該評估列出的配置中,沒有其他模型能以更少輸出達到相同分數。
幻覺是法律場景中特別敏感的風險,因為一個虛構引用就可能損及客戶信任、法庭可信度與多年累積的專業聲譽。Artificial Analysis 的資料顯示,Astra for Law 平均每項作業出現 0.03 次重大幻覺、0.06 次輕微幻覺;GPT-6.2 Astra 的重大幻覺為 0.06 次,而 Claude Opus 5.5 分別為 0.59 次與 0.51 次,約為 Astra for Law 的 20 倍與 8.5 倍。所有受測的 OpenAI 配置,重大幻覺率都低於 Claude Opus 5.5;Astra for Law 在符合全部通過條件的任務中,沒有出現重大幻覺。
書狀寫作與法律研究
除了廣泛法律任務,OpenAI 也公布LAB: USCL 的結果。這是 Harvey 與 Grubel 共同開發的評測,用來測試模型能否研究並撰寫美國真實聯邦案件中的書狀。模型會被放在書狀提交前的位置,針對同一方、同一爭點寫作;一種情境要求模型自行找出相關案例,另一種情境則提供案件紀錄與原律師引用的先例。AI 評分者依據律師審查與校準過的標準,讓不同書狀進行成對比較。
當模型必須自行研究法律時,Astra for Law 得分 1,844,Opus 5.5 為 1,817;當兩者都拿到案件紀錄與原律師引用的先例時,分數分別為 1,883 與 1,882,差距幾乎消失。前一個情境更能反映這次更新的重點,因為訴訟律師通常不會從一份已篩選好的判例清單開始,而必須先判斷哪些判決與爭點相關。Harvey 法律研究主管 Julio Pereyra 表示,Astra for Law 6.2 較先前 Astra 模型有實質進步,在成對比較中,近 90% 的情況下評審偏好它撰寫的書狀,同時準確性沒有因內容更深入而退化。
Vals AI 的 Legal Research Bench 則由執業律師提出美國聯邦與州法問題,答案必須覆蓋所有必要要點並通過來源檢查。9 月,Astra for Law 在約 46% 問題上取得滿分;在 11 月 16 日的評估中,它在 208 題中的 112 題取得滿分,比例為 53.8%,不到兩個月提升約八個百分點;若計入部分分數,則取得所有可用分數的 90.9%。在 Harvey 自家的 Legal Agent Benchmark 中,不同於前述 LAB-AA,GPT-6 Astra 完全符合要求的比例為 4.6%,GPT-6.2 Astra 提升到 14.6%,加入法律配置後再升至 16.2%,比基礎模型多完成約 11% 的問題。這組數字把基礎模型進步與法律配置本身的貢獻分開呈現。
實務使用與限制
實際使用情形顯示,Astra for Law 的價值不只是產生答案,而是成為律師檢視論證的工具。Sullivan & Cromwell 合夥人 John Savva 表示,早期版本在訴訟與交易事務中都展現出研究深度與對權威依據的敏感度,並被視為朝向以當前且完整研究為基礎的法律專用 AI 邁出重要一步。OpenAI 與律師事務所中的早期用戶,會把法規或法案交給模型,要求它站在反對立場提出最強論證,並用立法史、法院判決與其他語言版本法律文本檢驗自己的解讀。也有政策律師把法案原文與白話義務說明並列,用來分辨某項文字究竟只是建議,還是會形成強制要求。產品律師則用它盤點公司準備進入陌生產業時適用的規則,使第一次與外部顧問溝通時能直接聚焦爭點。法律專案經理把監管程序與公司政策轉成案件處理流程,讓系統判斷何時應補充資料、何時結案、何時升級給律師;另有團隊結合 ChatGPT 的網站建立工具,為常用法條製作註釋,讓同仁查看術語定義、連結解釋資料,並看到團隊過去對同一條文的建議。
這批資料的意義在於,它把法律 AI 的競爭焦點從單純問答,推進到可驗證的研究與書寫流程。模型配置路線也顯示,先把前沿模型能力當作底座,再以領域索引、指令和回饋迭代,能在短時間內改善特定任務表現。不過,限制同樣清楚:LAB-AA 滿分率只有 20.8%,Vals AI 法律研究基準為 53.8%,代表多數任務仍未被判定為完全符合全部要求。評估主要集中在美國法律,尤其聯邦與州法、美國案例法;雖然索引已加入英國、澳洲、加拿大等地資料,來源文章並未提供這些法域的完整表現證據。此外,評分依賴 Harvey、Artificial Analysis、Vals AI 與 AI 評分者建立的標準,能說明模型在界定任務上的能力,但不能直接等同於任何真實案件的策略成果。即使幻覺率下降,法律輸出仍須核對引用、權威層級與時效;64,000 個輸出 token 雖然比競爭模型少,仍是一項需要管理的成本變數。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。