背景:TPU 是什麼,為何一年推出四款系統
TPU(Tensor Processing Unit,張量處理器)是 Google 為機器學習工作量身打造的自家客製化晶片,最早在十多年前為了內部的語音辨識與語言翻譯需求而設計。經過八代演進,TPU 的應用範圍已大幅擴張:訓練與服務 Google 自家的 Gemini 模型、處理代理式(agentic)工作負載、為 Google Cloud 客戶提供雲端服務,最近甚至允許客戶把 TPU 直接部署到自己的資料中心。目前 TPU 已是一個快速成長的業務,擁有近 100 家客戶,涵蓋前沿 AI 實驗室、交易公司、零售商與大學等。
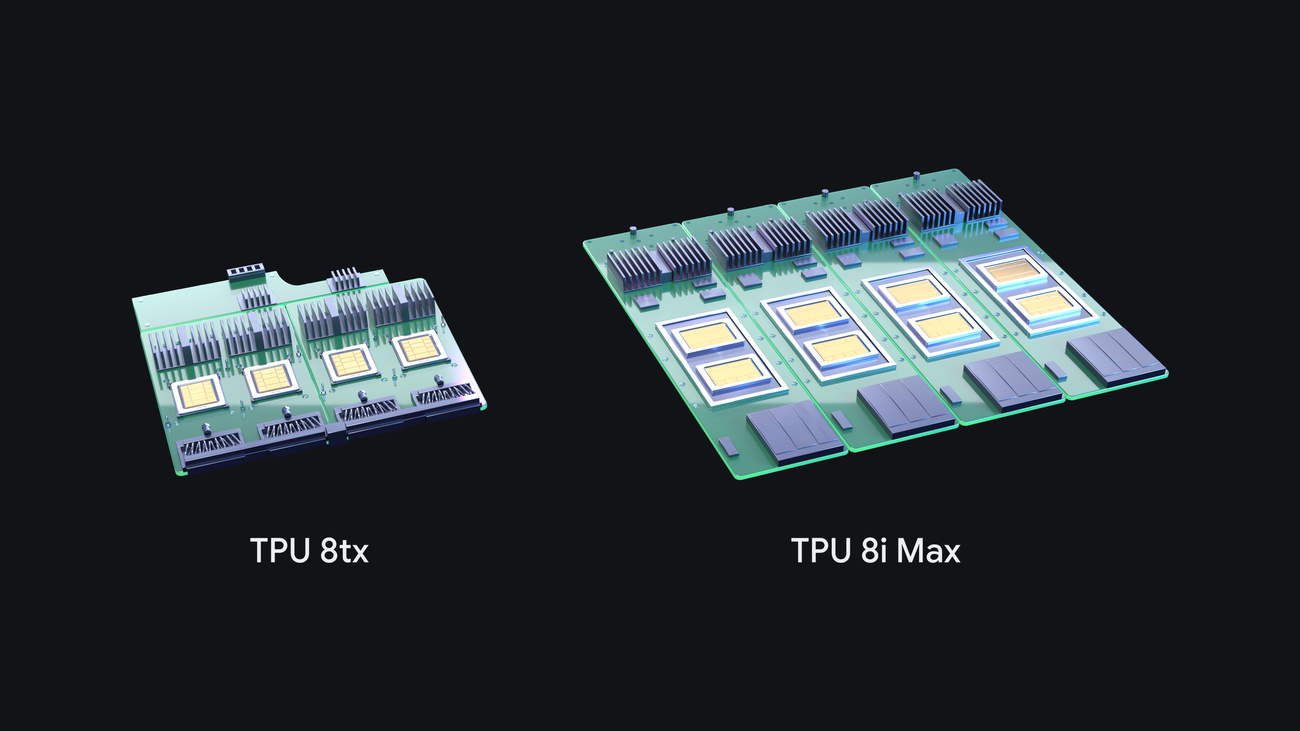
今年 4 月的 Google Cloud Next 大會上,Google 首次在同一世代推出兩款專用 TPU:TPU 8t 主打大規模訓練,相較前一代帶來最高 2.7 倍的訓練效能提升;TPU 8i 則是即時推論引擎,提供 80% 更佳的推論性價比。而在這篇由 Google AI 基礎設施資深副總裁暨技術長 Amin Vahdat 發表於 Google 官方部落格的公告中,Google 再追加兩款系統:TPU 8tx 與 TPU 8i Max,這是 Google 首度在單一年度內發表四款 TPU 系統。
核心內容:晶片之外的系統設計哲學
要理解這兩款新產品,得先分清楚「晶片」與「系統」的差別。設計一枚新晶片,意味著在矽晶圓上布局數十億個電晶體,是受物理定律與漫長製造週期約束的多年工程;而「系統」則是如何把運算、網路與儲存圍繞晶片組合起來,包括封裝方式等,能更快回應新興客戶需求。Google 從第一代 TPU 就押注系統平衡與模組化,把 TPU 視為 AI Hypercomputer 架構中的積木,讓工程師能快速調整封裝、高速記憶體、光學網路與安全配置,因此能在幾個月而非數年內推出專用超級電腦。這次兩款新系統正是建立在新晶片與既有 8t、8i 晶片的基礎上重新配置而成。
TPU 8tx:把機密運算做進硬體層
TPU 8tx 的目標是安全與機密推論,同時也適合小型訓練任務,主要客群是需要在最敏感資料上運行前沿或專有模型與自主代理的受管制企業與政府機關。傳統做法中,資料在儲存或網路傳輸時會加密,但一旦進入記憶體被處理時就必須解密,形成安全缺口。TPU 8tx 建立在與 TPU 8t 相同的晶片之上,搭配第五代 AMD EPYC CPU 主機,把安全直接做進硬體層,讓敏感資料與模型權重在「使用中」也保持受保護與隔離。它採用為即時推論設計的低延遲 Boardfly 網路,延遲比 TPU 8t 低達 2 倍,且效能損耗接近零。由於具備訓練級運算能力加上快速推論網路,組織可以在單一系統上同時運行與客製化模型:用私人資料微調、把大模型蒸餾成小模型、透過強化學習訓練代理,都不需要在不同叢集之間搬移敏感資料。
TPU 8i Max:用雙晶片封裝突破記憶體牆
TPU 8i Max 解決的是另一個問題:記憶體牆。當數十個 AI 代理同時在整個軟體程式碼庫或數小時的影片上進行推理時,記憶體頻寬很快就成為瓶頸。Google 的做法是把兩顆低延遲的 TPU 8i 晶片封裝到同一個模組上,讓運算與記憶體同步擴展:運算、SRAM 與 HBM 頻寬都是 TPU 8i 的兩倍,確保處理器持續取得所需資料,大型工作負載不會卡住。此外,由於它能在既有機架佔位空間內塞進兩倍的矽晶片面積,資料中心每平方英尺與每瓦所能部署的運算力都顯著提升。
至此,第八代 TPU 陣容形成完整分工:8t 負責大規模訓練、8i 負責低延遲推論、8tx 負責機密運算、8i Max 負責超大上下文與最高機架運算密度,覆蓋代理式 AI 生命週期的每個階段。
軟體生態:讓 TPU 變得像通用硬體一樣好用
早期只有少數公司需要 TPU 的算力,工程師得用最佳化框架與手工調校的程式碼。如今 Google 系統性地移除採用門檻,重點包括幾項。首先是開源 TorchTPU:PyTorch 程式碼與 Hugging Face 模型如今可直接在 TPU 上原生執行,無需改寫程式碼,主流開源推論引擎 vLLM 與 SGLang 也提供開箱即用的 TPU 後端。新的開源 TPU agent suite(預覽中)可外掛到 Claude Code、Cursor、Google Antigravity 等編碼工具,用自然語言完成 TPU 環境建置、瓶頸診斷與核心自動調校。開源的 XLA Serving Engine 則讓開發者用 Python 訓練模型後,直接在低延遲的 C++ 執行環境中跨 TPU、GPU 與 CPU 服務。
在實際效能上,於測試代理式編碼與長上下文任務的業界標準 InferenceX 與 AgentX 基準中,TPU 上的原生 vLLM-TorchTPU 軟體堆疊取得了領先的性價比成績。針對代理的狀態特性,新的 Agent Compute Engine 能在代理等待資料庫查詢、外部工具或人類回饋而閒置時,於毫秒內自動暫停工作階段並把工作記憶體移出晶片,降低營運成本。開源的 TPU Sync 則把晶片 HBM、主機 DRAM、共用儲存與資料中心網路統整成一個共同設計的記憶體階層,自動把龐大的 KV 快取分層移出晶片,將 KV 傳輸延遲與首字元時間(TTFT)降低超過 90%。
在大規模調度方面,Google Kubernetes Engine(GKE)上的 Cloud Pathways 正式可用,讓客戶用單一控制器架構編排多個 TPU slice,就像操作一台本機一樣,並具備硬體中斷時的容錯能力。GKE 動態切片也正式推出,透過光交換技術(OCS)把實體硬體供應與邏輯切片組成解耦,可即時把 TPU 立方體合併成更大拓撲或切分為更小的隔離工作負載,將工作啟動時間縮短最多 5 倍、故障恢復加速最多 4.5 倍。
脈絡解讀:協同設計與代理時代的算力需求
Google 強調,能在一年內推出四款 TPU 系統與統一的開源軟體堆疊,靠的是晶片架構師、網路工程師、編譯器團隊與 Google DeepMind 研究人員並肩協同設計。他們甚至用 AI 來加速打造下一代 AI 基礎設施:從 DeepMind 的 AlphaChip 強化學習系統,到用 Gemini 在數小時內而非數週完成晶片布局,TPU 驅動的 AI 服務正在加速 TPU 硬體本身的開發。這背後的市場訊號也很明確:運算需求正從「人類尺度」轉向「代理尺度」,企業需要能處理超大上下文窗口的推論硬體,而受管制產業則需要硬體級加密能力,兩款新系統正是回應這兩種新需求。
影響與限制
對企業而言,這套組合的實務意義在於:以前需要在不同硬體叢集之間搬移資料才能完成訓練與推論的流程,現在可以在單一 TPU 系統內閉環完成,對資料治理是重大簡化;而開源軟體堆疊則大幅降低了從 NVIDIA GPU 生態遷移的阻力。不過需注意的限制也不少:TPU 生態仍在 Google Cloud 與特定部署模式內, benchmark 成績來自 Google 自家的軟體堆疊與其選定的開源模型組合,實際表現會因工作負載而異;文中提到的多項工具(如 TPU agent suite)仍處於預覽階段,軟體最佳化的長期承諾也有待驗證。整體來看,這次發布反映的是 AI 基礎設計競爭的新階段:比的不只是單一晶片峰值效能,而是圍繞晶片所構建的系統、軟體與調度能力的整體戰。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。