背景與問題
合約審閱之所以難以自動化,不只是因為文字量龐大,而是每一處修改都可能同時牽涉語意、法律風險與公司政策。外部交易方提出一條增刪文字,法務人員必須判斷它只是措辭調整,還是會改變責任上限、賠償範圍或履約義務;接著還要對照公司立場,決定接受、拒絕或改寫,並用能被對方理解的語氣寫成註解。Uber 面對的正是這種高重複、高責任密度的流程。InfoQ 一篇由 Leela Kumili 撰寫的報導指出,Uber 將這套流程做成整合於微軟 Word 的 Legal Redlining Agent。Redlining 在合約語境中指在文件上標出紅線式增刪修訂;這個代理會讀取外部方提出的變更,辨識意圖、評估風險,再依公司法律政策提出回覆建議。Uber 表示,上線後平均合約審閱時間降低超過 20%,AI 產生決策的準確率為 91%。這裡所說的決策,是系統對條款處理方式提出的建議,最終批准權仍留在律師手上。
核心內容
Uber 在 2024 年初開始發展第一代系統,並於 2025 年與公司法律團隊進行試點。第一代做法以 RAG 為主。RAG 是 retrieval-augmented generation,也就是檢索增強生成,核心觀念是先從外部知識庫找出相關依據,再讓語言模型根據這些材料產生回答,目的在於減少憑空發揮,並讓輸出更貼近組織既有的規範。Uber 最初讓系統從法律 playbook 中擷取相關章節,用來引導模型回應。Playbook 在此指公司累積的法律政策與 negotiating 立場文件,是律師處理同類條款時的重要參考。不過,單靠這層檢索並不足以處理真實合約協商,因為語義相近的條款未必代表相同風險,歷史文件也不一定覆蓋當下的交易情境,模型在談判語氣與未見過的案例上容易失真。
回饋機制與.runtime 流程
為了解決上述問題,Uber 加入回饋迴路,不只是記錄某次建議是否被接受,而是保存律師的決策、理由與最終編輯後的文字。這讓系統能檢索「類似條款過去如何被處理」,而不是只知 slim 道過去某個建議被接受或拒絕。運行時,系統先透過相似度搜尋與中繼資料篩選,把數千筆歷史互動縮小到約二十個候選案例。中繼資料是附屬於資料上的結構化資訊,可用來限定搜尋範圍;相似度搜尋則負責找出語意上接近的條款與處理方式。之後,第二個語言模型過滤階段會再評估這些候選案例是否真正相關。為了避免舊案例完全支配判斷,系統採用指數衰減權重,讓近期決策具有較高影響力,同時保留較早範例。該權重的半衰期目前設定為 365 天。這個設計反映出一點:企業法律知識不是靜態文件,而是會隨交易經驗、政策調整與風險偏好持續變動。
系統架構與控制權
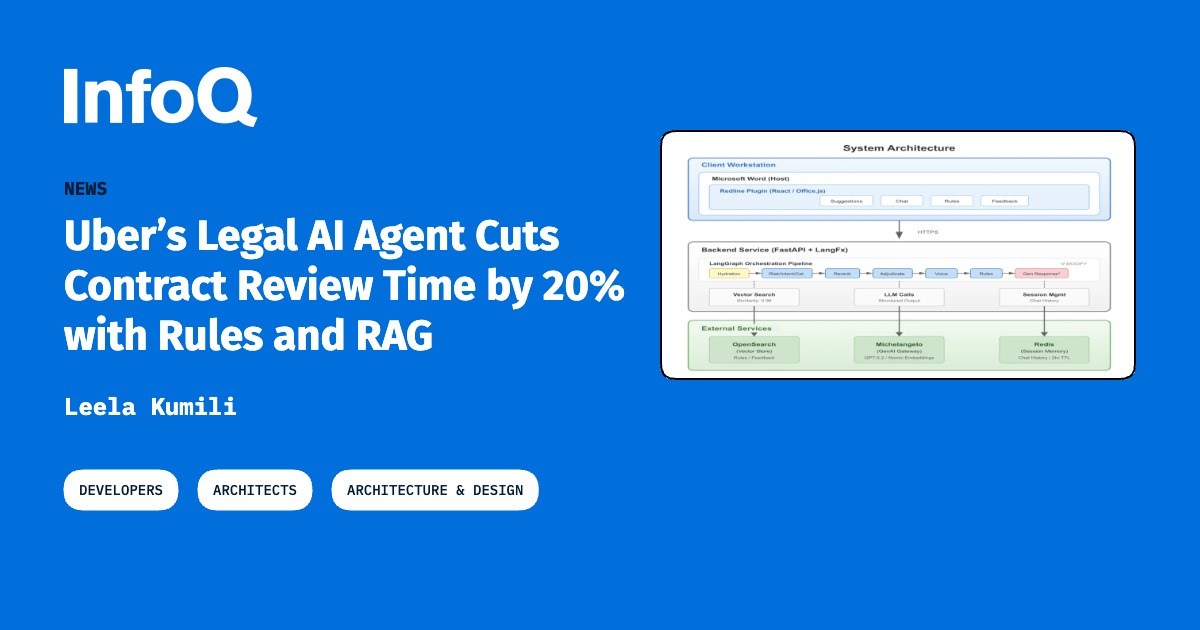
在實作層面,Uber 使用 React 與 TypeScript 建立 Word 增益集,讓律師能在原本熟悉的文件中直接使用;後端以 Python 組成,並透過 LangGraph 編排代理流程。LangGraph 在此可理解為將多步驟代理工作流程拆成節點、分支與狀態的框架,讓意圖辨識、風險評估與政策查找等工作能被平行處理。OpenSearch 負責存放向量化的法律規則與歷史回饋,支援語意檢索;向量化是指把文字轉換為可被數值比較的表示形式,使系統能找出語意相近的內容。Redis 則用來維持會話狀態,讓使用者在追問時仍能延續同一個審閱脈絡。值得注意的是,Uber 沒有把判斷完全交給語言模型。法律團隊定義期望的語氣與風格,工程師維護模型輸入結構與應用流程;語言模型處理需要語境解讀的條款建議與協商表达,確定性規則引擎則负责不可協商的 legal requirements。當某條規則命中時,規則引擎會覆蓋模型建議。最後還有驗證步驟,把生成回覆與檢索到的規則再次核對。
實際影響
這套設計的意義,不只是把合約審閱變快,而是把自動化、法律治理與人工責任重新排列。Uber 的公開說法顯示,平均審閱時間下降超過 20%,代表系統已能承接部分重複辨識與初稿建議工作;而 91% 的準確率則說明它在多數情況下能提供可用判斷。不過,這個數字不應被解讀為法律風險已經消失。合約條款的影響往往是不對稱的,少數錯誤可能带来远高於其他案例的成本,因此律師覆核仍是必要防線。Uber Engineering 在 LinkedIn 上把問題概括為:如何讓 AI 簡化重複的合約審閱,同時讓律師保持控制。該公司的回答不是追求 fully autonomous 的法律代理,而是讓系統先完成搜尋、比對、草稿與提示,讓法律專業人員把時間集中在例外、高风险與需要談判判斷的部分。
限制與後續方向
限制同樣清楚。首先,RAG 的效果取決於政策文件是否完整、檢索是否找對段落,以及模型是否能正確解讀檢索結果。若法律 playbook 沒有涵蓋某類交易安排,或檢索器挑出不相關案例,生成建議仍可能偏離公司立場。其次,歷史回饋能讓系統更貼近實務,但也可能把過去的風格與盲點一併帶入;時間衰減與中繼資料篩選能降低這個風險,卻不能取代政策維護。再次,確定性規則引擎適合處理不可協商要求,但規則必須隨法規與公司政策更新,否則會形成新的落差。InfoQ 報導也提到,Uber 仍在探索 Claude Code、OpenCode 等代理執行框架,以及名為 skills 的技能模組,用來結構化並自動化代理工作流程;這些屬於研究方向,不宜視為已驗證的正式成果。Uber 另計畫研究 legal ontologies 與 knowledge graphs,也就是把法律概念與關係轉成機器可處理的結構,讓不同案例有一致語意基礎。整體而言,這個案例的重要之處在於它展示了一種較成熟的企業 AI 落地方式:不是單純換上更強的大模型,而是把檢索、規則、回饋、驗證與人工審批結合成可治理的流程。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。