背景與問題
Spring Batch 在 JVM 生態系中擔任批次處理的預設框架已超過十年,透過 chunk 導向的 reader、processor、writer 組成 job 與 step,並以中繼資料儲存庫(job repository)讓批次執行具備可重啟性。對於夜間 ETL、財務對帳與資料驗證這類單機工作負載,它幾乎是最省事的選擇。真正的壓力出現在單機容量不再夠用的時候:原本能在批次時間窗內完成的對帳作業,隨著資料量成長而超時,自然的反應就是把工作攤到多台節點上。Spring Batch 官方的答案是遠端分割(remote partitioning),由 manager step 把工作切成數個 partition,再透過 Apache Kafka、RabbitMQ 或 JMS 這類訊息中介軟體(message broker),搭配 Spring Integration 派發給各個 worker。這是成熟且經過驗證的做法,但代價是多出一整層需要架設、維護、監控與保護的訊息基礎設施。許多團隊本身就有受良好管理的關聯式資料庫——因為 Spring Batch 的 job repository 本來就需要它——卻不願意只為了批次分割而維運一套訊息叢集。InfoQ 刊登、由 Janardhan Reddy Chejarla 撰文、Michael Redlich 審核的這篇文章,正是說明如何只用共享資料庫,在中小規模叢集上協調一個具容錯能力的分散式 Spring Batch job。
核心設計:資料庫即協調平面
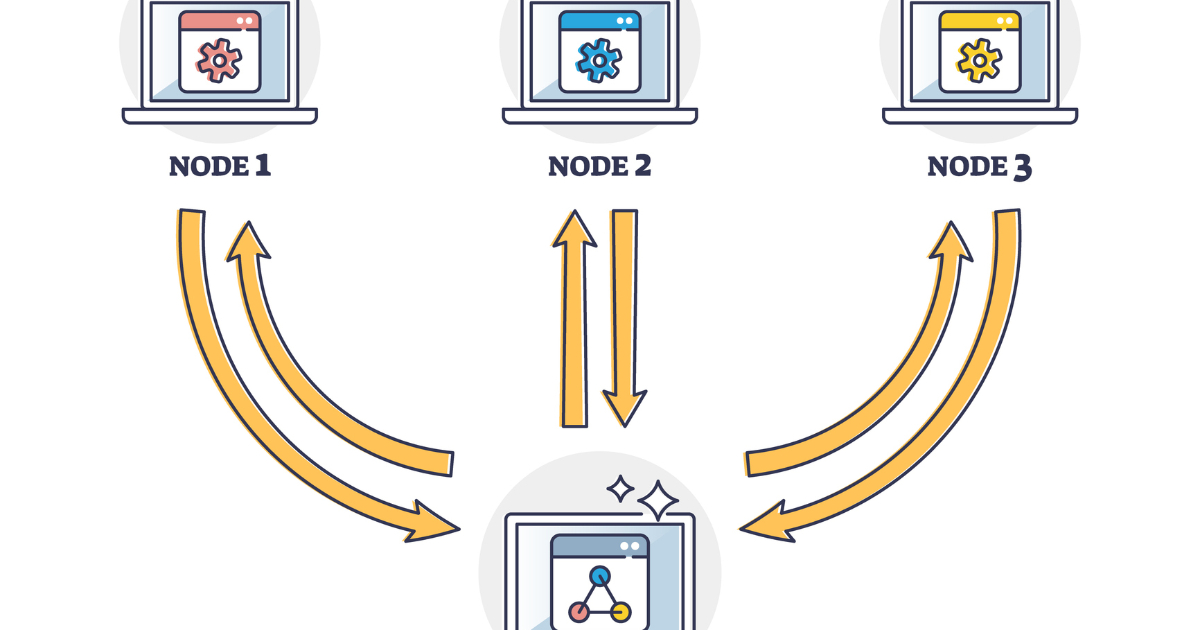
這個模式把 Spring Batch 原本就需要的那個資料庫,同時當作協調平面(coordination plane)使用,不引入 broker,也不依賴 Apache ZooKeeper 這類協調服務或部署平台。所有叢集狀態都寫進一般 SQL 資料表,代表整個叢集的運作狀態可以用 SELECT 指令直接檢查。設計上新增三張表:BATCH_NODES 是節點註冊表,記錄每個節點的狀態(active 或 unreachable)、最後心跳時間與目前負載;BATCH_PARTITIONS 追蹤 partition 生命週期,每個 partition 對應一個獨立的 Spring Batch StepExecution,並記錄指派節點、狀態(pending、claimed、completed、failed)以及該工作是否允許在故障後轉移到其他節點;BATCH_JOB_COORDINATION 則把每次 job execution 綁定到它的 master 節點與 manager step。值得注意的是,這個設計並沒有消除「共享且持久的 job repository」這項需求——partition 的 ExecutionContext 由 master 寫入、由執行它的節點讀取,這本身就是跨 JVM 的中繼資料交換,官方遠端分割也要求同樣的儲存條件,broker 在官方方案裡只負責傳送 partition 指標而非資料。換言之,這個模式移除的是 broker,而不是 repository。
對開發者的影響之所以小,關鍵在於 Spring Batch 早就把分割式 step 拆成兩個獨立職責:Partitioner 介面決定怎麼切工作,產生每個 partition 一份的 ExecutionContext;PartitionHandler 則決定這些 partition 怎麼被執行。內建的 TaskExecutorPartitionHandler 在本機執行緒跑,官方遠端分割則換成走 broker 的 MessageChannelPartitionHandler。這個模式做的事情只是提供自己的 PartitionHandler:它在原本 broker handler 的位置,改為把 partition 寫進資料庫並監控其執行進度。Worker step 維持一般的 chunk 或 tasklet 實作,結果透過標準 StepExecutionAggregator 聚合,重啟也走標準 JobRepository。習慣本機分割的開發者只需要替換兩個 bean。把同一個部署單元變成叢集成員也只是組態問題:一個開關啟用自動設定後,節點會自動註冊、開始心跳、開始輪詢,透過心跳間隔、輪詢間隔、每節點並行數與兩個心跳老化門檻來調整行為。
master 的選取是刻意去中心化的。系統中沒有為整個叢集選出的常駐 master,因為那會重新引入領導者選舉機制與單點故障——正是當初拿掉 broker 想避開的東西。改為由啟動某個 job 的那個節點擔任該次執行的 master,僅限這一次執行;兩個節點各自啟動 job,就會同時有兩個 master。由於 master 身分被限定在單一 job execution,失去 master 只影響那一個 job,不會癱瘓叢集。master 的職責也全部透過資料表完成:先寫入協調記錄、為每個 partition 寫入 PENDING 列並標記指派節點、進入監控迴圈定期重新指派因節點移除而成孤兒的 partition,最後在沒有未完成工作時結束 job 或標記失敗。Worker 從不主動聯絡 master,master 也不呼叫 worker,一切決策都靠讀寫這些資料列完成。
工作切分、領取與故障恢復
官方遠端分割常見的盲點是:工作在派發之前就已經切好,grid size 往往是寫死的常數,並不知道當下實際有多少 capacity。沒有 broker 之後必須正面處理這件事。master 在切割前先查詢資料庫確認目前活著的節點數,把這個數字傳給 partitioner,讓 partition 數量按照當下叢集規模決定,例如每個活節點配置一到兩個 partition。指派策略可以是 round-robin 平均分配、限定 n 個節點,或是 least-loaded 把 partition 交給回報負載最低的節點。需要認清的取捨是:指派在切割當下就固定,這是放置而非執行期再平衡,提早做完的節點不會從慢的節點手上拉工作——broker 的 pull 語意免費提供的動態再平衡,在這裡被捨棄,只有節點故障才會移動工作。
領取工作的正確性靠一條受保護的 UPDATE 保證:worker 輪詢指派給自己的 PENDING partition,執行 UPDATE batch_partitions SET status = ? 時,WHERE 條件要求 step_execution_id 與 assigned_node 相符,且 status 必須仍在 PENDING 或 CLAIMED。這個 compare-and-set 式的寫入確保一旦 partition 抵達終態(COMPLETED 或 FAILED)或已被重新指派,任何遲到的寫入都會比對不到資料列而失效。若一個停滯的節點正好在 master 重新指派時完成工作,只有一方寫入會成功:master 先動手,完成寫入會因 assigned_node 不再指向該節點而失敗;節點先動手,重新指派會因狀態已是終態而失敗。這不是用 SELECT FOR UPDATE SKIP LOCKED 打造的競爭式佇列——partition 是預先指派的,受保護更新管的是生命週期而非派發本身。broker 透過佇列保證的「一個 partition 只給一個節點」,在這裡改由資料列層級的狀態轉移達成。
節點故障透過心跳與兩階段恢復處理。每個節點定期用資料庫時鐘更新心跳時間戳,活性檢查也比對同一個時鐘,因此不受各機器本地時鐘偏移影響。偵測與清除是去中心化的,每個節點都跑清除掃描,沒有單一監控者死亡的問題;重新指派則由受影響 job 各自的 master 在監控迴圈中執行。第一階段中,心跳超過 unreachable 門檻(預設約十秒)的節點被標記為 unreachable;第二階段中,持續超過清除門檻(預設約三十秒)的節點被移除。兩個門檻之間的寬限期是有意設計的:短暫的 GC 停頓或網路抖動只會讓節點暫時標記為 unreachable,下次心跳即恢復,只有持續失聯才升級為移除。節點被移除後,其未完成 partition 依契約處理:可轉移的重新指派,不可轉移的標記為 FAILED 讓 job 乾淨失敗,而不是冒著重複執行的風險。
正確性契約、適用範圍與限制
這個模式最關鍵的設計是把可轉移性視為明確契約而非推測。每個 partition 由 partitioner 標記為 transferable 或 non-transferable:可轉移代表工作是冪等的(idempotent),故障後可在別處重跑,屬於 at-least-once 保證,可能執行兩次;不可轉移代表 at-most-once,節點遺失時寧可標記失敗也不搬移。對某個數值範圍加總是可轉移的;對外部帳本追加紀錄或呼叫只能計費一次的 API 則不是。失去心跳的節點會停止領取工作並中止已領取的 partition,這種 fencing 縮小雙重執行的窗口,但只是盡力而為——被硬暫停的 JVM 可能在醒來後完成已被重新指派的工作,所以可轉移工作必須真正冪等。系統絕不妥協的一條是:任何 partition 都不會被靜默遺失,它要不是完成,就是讓 job 失敗。另外,master 故障時採 fail-and-restart 而非原地恢復:存活節點發現仍在進行中的協調記錄而 master 已離開時,會原子式接管並標記失敗,讓 job 可乾淨重啟,因此重啟本身也必須冪等;自動接管(不重啟直接續跑)列在路線圖上,尚未解決的是兩個節點可能同時自認為 master 的安全問題。
這個模式的甜蜜區間大約是二到二十個節點,上限不是固定節點數而是資料庫競爭。心跳、輪詢與狀態更新全是資料庫流量,在中小規模叢集上很輕,但會隨節點數與 job 並行度成長,直到與批次工作本身競爭同一個連線池與 I/O。適用條件是:資料庫已存在且管理良好、營運簡潔與成本低於原始規模的優先級、加入訊息中介層不切實際(受限環境、維運能量有限、需要跨雲可攜性)。相反地,叢集成長到數十個節點以上、需要次秒級協調延遲、平台已共享成熟串流骨幹,或工作本來就適合 broker 的遞送與排序語意時,仍應選擇 broker。與相鄰方案相比,官方遠端分割沒有內建的活節點感知與故障後自動重指派,正是此模式補上的缺口;Spring Cloud Task 的 deployer 方案雖也不用 broker,但它是透過 Kubernetes 這類平台為每個 partition 佈建 worker,而非協調一組常駐 JVM 節點;Quartz、db-scheduler、JobRunr 等資料庫協調排程器目標是排程或一般背景工作,而非 Spring Batch 分割式 step。這個設計取材自作者建立並維護的開源框架 spring-batch-db-cluster-partitioning,曾發表於 Journal of Open Source Software,完整的多資料庫 schema、程式碼與可執行的多節點範例都收錄在其開源儲存庫中。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。