在雲端儲存與協作領域,處理多樣化的檔案格式一直是技術挑戰的核心。Dropbox 面對成千上萬種不同格式的檔案,最初僅需要提供簡單的預覽功能,讓使用者在不下載檔案的情況下能快速查看內容。然而,隨著生成式 AI 的興起,對內容的需求從單純的視覺呈現,轉向了深度解析、文本提取與向量化,以支持大語言模型(LLM)的輸入。為了應對這一轉型,Dropbox 將其內部的預覽服務演進為名為 Riviera 的通用內容處理平台,將原本碎片化的檔案處理邏輯轉化為可重複利用的基礎設施。
背景與設計核心:從單一功能到可組合管道
Riviera 最初的定位僅是一個內部服務,負責生成各種檔案格式的預覽圖。在早期開發中,如果為每一種檔案格式都建立獨立的處理服務,將會導致維護成本極高且功能重複。因此,Dropbox 的工程團隊採取了分解策略,將內容處理過程拆解為多個可重複使用的轉換能力(Transformations)。
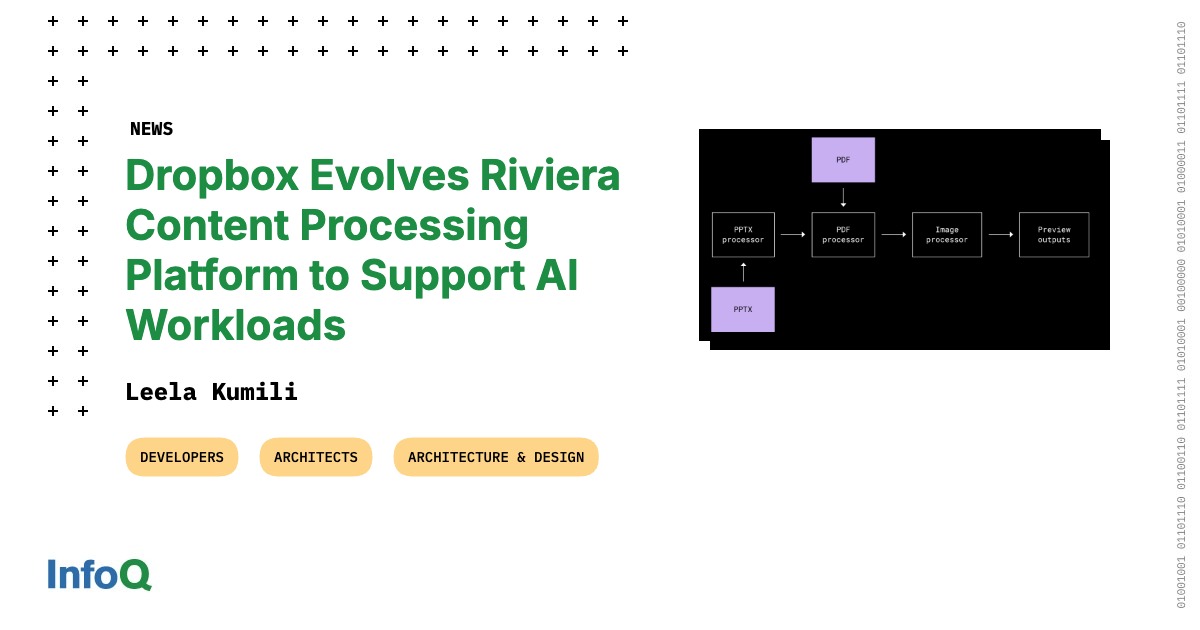
這種設計的核心在於可組合性(Composability)。以 PowerPoint 檔案的預覽生成為例,系統不再將其視為單一任務,而是將其分解為兩個步驟:首先將簡報轉換為 PDF,接著將 PDF 的每一頁轉換為影像。這種將大任務拆解為小單元的做法,使得不同的處理管道可以像積木一樣組合,只要定義好轉換順序,就能快速開發出新的處理流程,而不需要重新撰寫核心邏輯。
架構實現:編排與執行的分離
為了支持每秒數十萬次的轉換量,Riviera 採用了編排(Orchestration)與執行(Execution)分離的架構。中央編排組件負責驗證請求、組合轉換管道、將工作分派給後端執行端,並管理快取機制。而具體的轉換能力則由獨立的執行端(Workers)負責,並透過插件模型(Plugin Model)實現。
這種插件化設計至關重要,因為它允許工程團隊在不變動核心編排層的情況下,隨時增加對新檔案格式的支持或引入新的轉換能力。此外,快取機制在處理海量數據時發揮了關鍵作用, intermediate results(中間結果)的快取讓多個 AI 操作可以重複使用先前生成的內容,大幅降低了重複計算的資源損耗。目前,該平台支持超過 300 種檔案格式與 100 多種轉換能力,每日處理請求量約 25 億次,處理數據量接近一個 Exabyte(艾位元組)。
對 AI 工作負載的賦能與實務應用
Riviera 的演進讓 Dropbox 能夠將既有的內容處理基礎設施直接應用於 AI 產品線。例如,在實現 AI 摘要或問答功能時,系統會將內容轉換為文本,進而生成 Embedding(向量嵌入,將文字轉化為機器可理解的數值向量),作為 LLM 的輸入。
在 Dropbox 的 AI 助手 Dash 中,Riviera 扮演了數據準備的角色。Dash 需要處理來自 Dropbox 以及第三方連接服務的內容,Riviera 提供提取與標準化(Normalization)的轉換功能,在將內容索引化之前先將其統一格式,確保 AI 搜尋的準確性。
此外,Dropbox 已將 Riviera 的部分能力通過公開 API 開放。開發者可以使用異步端點(Asynchronous Endpoints)將文件轉換為 Markdown 格式、對音視頻進行轉錄,或提取結構化元數據。其中,Markdown API 特別重要,因為 Markdown 是一種輕量級標記語言,非常適合用於 LLM 的索引與渲染,能讓模型更精準地理解文件的結構。
影響、限制與技術差異
Riviera 與一般的通用提取框架(例如 Apache Tika)有顯著不同。Apache Tika 主要專注於偵測、解析並從多種格式中提取文本與元數據,而 Riviera 則是一個完整的平台級解決方案,它將轉換插件、管道組合、異步執行、快取以及中央編排完整地整合在一起。
這種平台化的趨勢也延伸到了外部開發者生態。例如,社群中出現了將 Riviera 的 Markdown 提取功能與 Conductor OSS(一種工作流編排工具)結合的開源整合,讓開發者能將 Dropbox 的內容提取能力直接納入 RAG(檢索增強生成,一種結合外部知識庫提升 AI 回答準確性的技術)的工作流中。
然而,這種高度依賴編排與快取的架構也帶來了複雜性,尤其是異步處理模式要求開發者必須處理工作識別碼(Job ID)的輪詢與狀態追蹤。儘管如此,透過將內容處理從單一產品功能提升至通用平台層級,Dropbox 成功地將過去累積的檔案處理經驗轉化為 AI 時代的競爭優勢,實現了從儲存工具向智能內容處理平台的跨越。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。