背景:AI Agent 的品質問題往往不會觸發警報
當 AI Agent 在生產環境中出問題時,情況通常和傳統軟體故障不同。傳統的基礎設施監控看的是 CPU 使用率、錯誤率、延遲這類指標,但 Agent 型應用有一種更隱蔽的退化:HTTP 回應一切正常,請求也成功返回,內容卻是錯的。例如 Agent 忽略了使用者的偏好、跳過了本該呼叫的工具、或在委派給其他 Agent 的過程中弄丟了關鍵資訊。這類「沉默的品質退化」不會讓任何監控面板變紅,卻會直接侵蝕使用者對系統的信任。
為了解決這個問題,Google 在 2026 年 11 月開源了 AQuA(Ambient Quality Agent,環境品質代理),一個用來分析生產環境中 AI Agent 對話紀錄、驗證重複失敗模式、並對照已部署原始碼版本追查根本原因的參考實作。據 InfoQ 的報導,這個工具的定位不是攔在請求路徑上的品質閘門,而是旁觀式的診斷系統。
核心內容:旁路架構與五階段分析流程
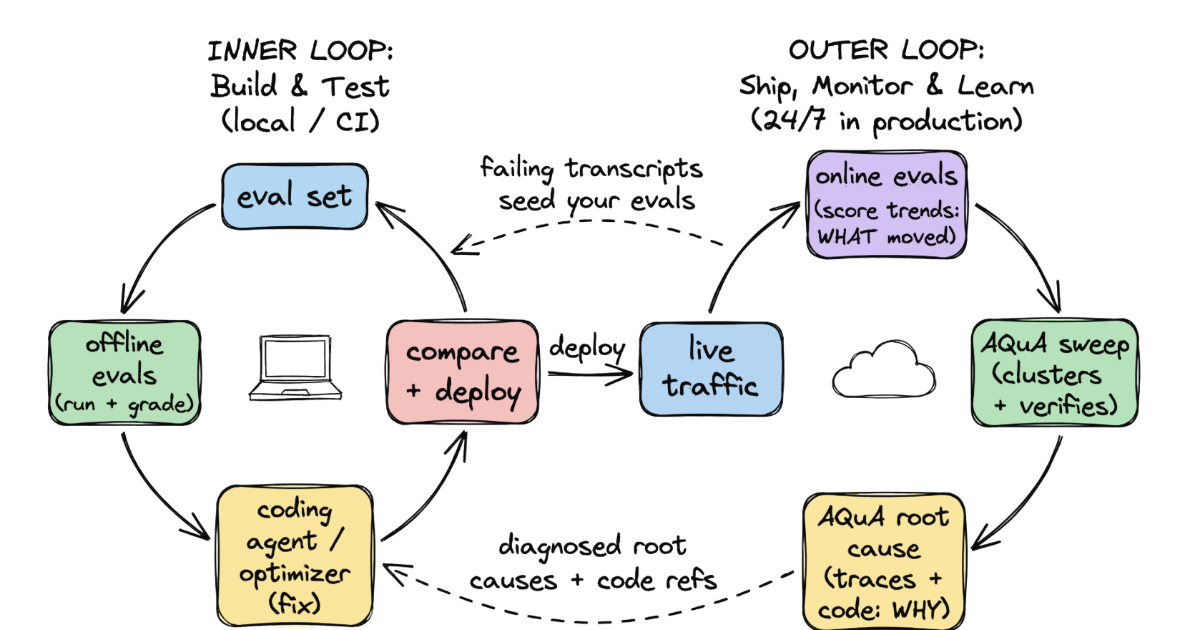
AQuA 的運作方式是和 Agent 一起部署在 Google Cloud 上,但不位於請求處理路徑之中,而是從 Cloud Trace、Cloud Logging 或 BigQuery 讀取遙測資料。每次執行最多取樣一千個近期對話session,再經過五個階段處理:取樣、審查、將發現聚類、驗證候選聚類、以及持續追蹤問題。開發者可以透過一份 goal.md 檔案定義領域特定的品質標準,也能加入確定性的自訂指標。執行時機可以排程定期跑、在每次部署之後觸發,或按需手動執行。
在根本原因分析方面,AQuA 會拿失敗的session與部署當下捕捉的不可變原始碼快照做比對。它的診斷 Agent 會找出相關的程式碼或指令內容,明確引用檔案與行號範圍,當問題根源在儲存庫內時還會提出修改建議;如果根源在外部,它也能把失敗歸因於外部依賴、工具之間的交接、或檢索到的資料。值得注意的是,AQuA 不會自動套用修復,也不會自動開 pull request,最終決定權仍留在開發者手上。
驗證結果:旅行應用實測與可重放的改善
Google 用一個多 Agent 旅行應用的三十二個session做評估,AQuA 找出四十二項發現,歸納成九個候選聚類。驗證器會對每個候選聚類檢查最多三份完整對話紀錄,結果否決了三個缺乏依據的聚類,留下六個已驗證的問題。其中兩個相當具代表性:一個是繞過了座位可用性檢查,另一個是在任務委派過程中弄丟了旅客的素食偏好。開發者修改提示詞並重放這些session之後,繞過座位選擇的情況從十五個session降到兩個,飲食偏好遺漏從七個降到零,通過全部檢查的session則從五個增加到十三個。不過要留意,這些數字來自受控的重放環境,並非真實生產流量的統計。
技術或脈絡解讀:可信度建立在引用而非自評分數
AQuA 設計上的一個關鍵理念,用 Google 部落格的話來說,就是「洞見的價值在於它的引用,而非自我報告的信心分數」。每項發現都會連結到支持它的追蹤紀錄,提出的根本原因必須指向已部署快照中真實存在的程式碼行。這種設計大幅降低了 AI 診斷常見的幻覺風險:結論可以被人工核對,而不是只給一個看似客觀的分數。
追蹤機制方面,發現會被標記為 NEW、RECURRING,或在十四天內沒有再被觀察到之後自動標記為 RESOLVED。這讓品質問題的修復進度變得可追蹤。在生態系的位置上,Google 自家的 Agent Platform 評估服務支援回歸測試與生產品質監控,Arize Phoenix 提供開源的追蹤與評估能力,而 AQuA 的獨特之處在於聚焦於生產失敗的分組、驗證,以及把已驗證的發現連結回部署的原始碼。Redcore 的工程經理 Dmytro Aprelenko 在 LinkedIn 上回應表示,Agent 編排確實需要更好的持續性診斷,才能及早抓住這類循環性的失敗。
影響與限制:驗證機制過濾誤報,但覆蓋率有限
AQuA 的聚類驗證機制能有效過濾誤報,但它無法確認每一個session都表現出相同的失敗模式,取樣機制也可能漏掉罕見的失敗;此外,重放未必能完整重現外部的狀態,例如第三方服務當下的回應。這些是 Google 自己也明確指出的限制。
對實務團隊而言,AQuA 的意義在於把「生產環境中 Agent 到底壞在哪裡」這件原本高度依賴人工翻log的工作,變成一個可排程、可驗證、可引用原始碼位置的流程。它不替你修東西,但把從「發現異常」到「定位到某一行程式碼」之間最耗時的環節自動化了。對正在把 Agent 推上生產環境的團隊來說,這類旁路式的品質診斷,很可能會成為 observability 工具鏈中越來越標準的一環。開源實作也讓團隊能把生產環境的 Agent 診斷整合進自己的開發與評估工作流,而不是被鎖在特定平台內。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。