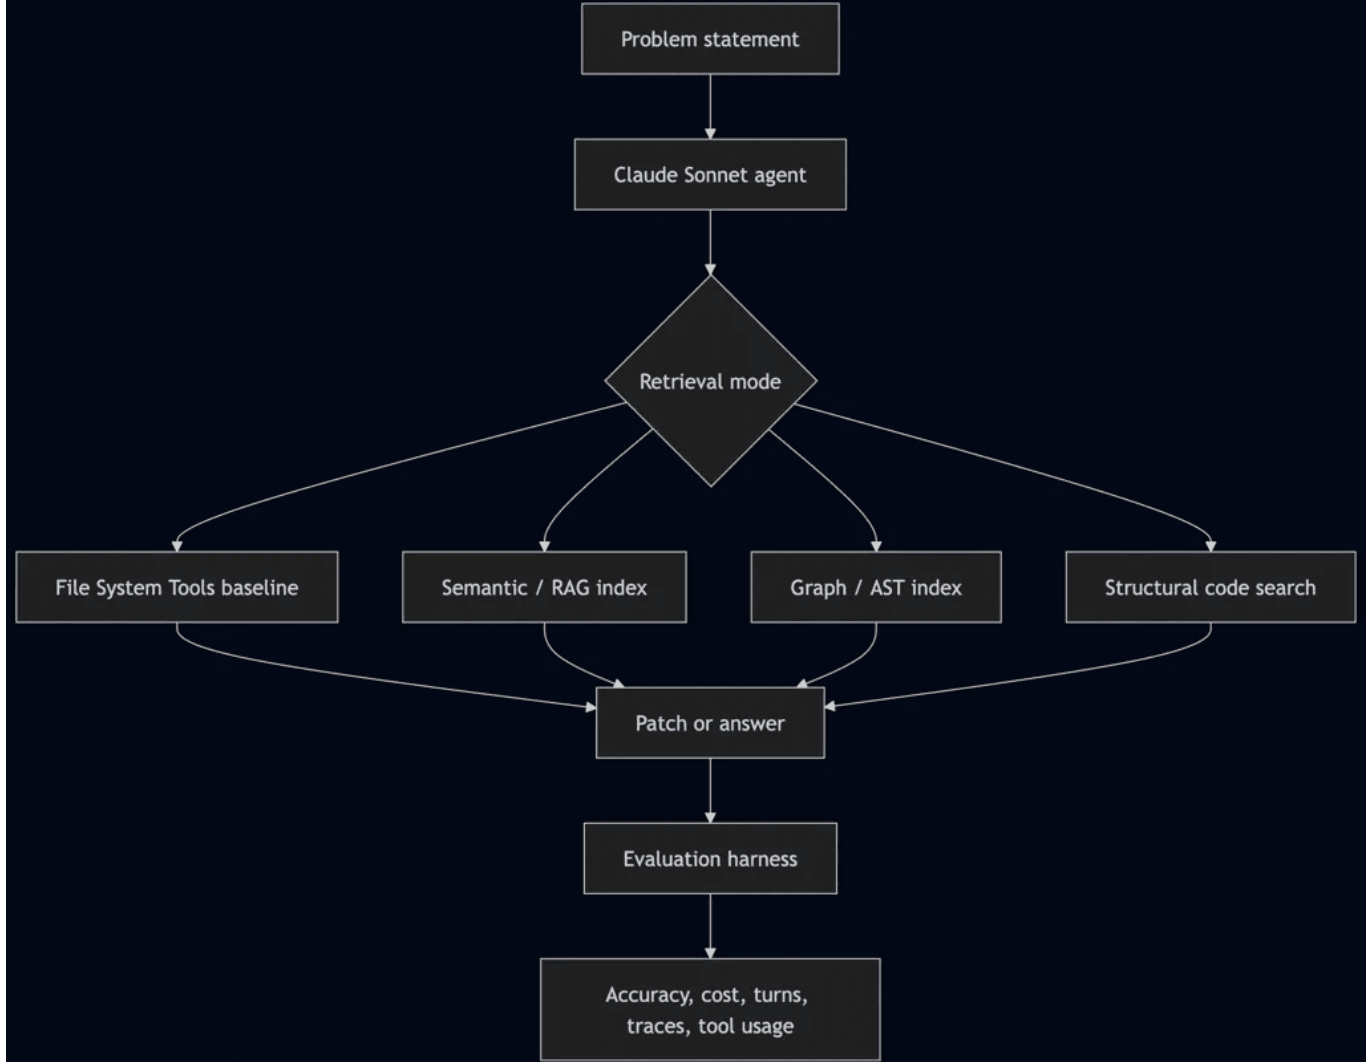
AI 編程代理(coding agent)在大型程式碼庫中工作時,第一個難題往往不是寫出程式碼,而是找到正確的上下文。當代理需要修改一個函式、追蹤某個設定的來源,或理解跨模組的依賴關係時,它必須先知道去哪裡找資料。近年常見的做法是在代理與程式碼庫之間加入一層檢索機制,讓代理不必逐檔翻找,而是透過索引、語義搜尋或符號查詢取得相關片段。然而,檢索層是否真的提升任務完成率、是否真的節省成本,一直缺乏有系統的比較。JioHotstar 的工程團隊針對這個問題做了一組基準測試,並將結果公開在該公司的部落格;InfoQ 於 2026 年 11 月 11 日由 Leela Kumili 報導了這項評估。負責這項工作的 Abhishek Bansal 是 JioHotstar 的高級主任工程師,他與團隊比較了六種協助代理導航大型程式碼庫的方法,試圖回答一個實務問題:什麼樣的檢索方式,適合什麼樣的工程任務。
這項評估比較的六種方法,包括最基礎的檔案系統工具、Sourcebot、Graphify、CocoIndex Code、Repowise,以及 JioHotstar 內部自行建置的檢索增強生成(Retrieval-Augmented Generation,RAG)管道。檔案系統基線的做法是把倉庫直接檢出到本地,讓代理使用標準的搜尋與檔案操作,例如以文字搜尋找關鍵字、開啟檔案閱讀內容、列出目錄結構。Sourcebot 則提供索引化的文字搜尋、符號定義查詢、引用查找與檔案讀取,讓代理能快速定位某個函式被誰呼叫、某個型別在哪裡定義。其餘工具各自偏向結構化分析、程式碼圖譜或語義索引。測試資料方面,團隊使用 SWE-bench 與 CodeScaleBench 的子集,另外設計了一套針對 JioHotstar 自家程式碼庫的問答測試工具。求解模型固定為 Claude Sonnet,衡量指標包含任務準確率、權杖(token)消耗、代理輪次,以及工具本身的可用性。
測試結果並未指向單一贏家,而是呈現出明顯的任務依賴性。檔案系統基線在具體、界線清楚的工程任務上仍具競爭力,代理只要會搜尋文字與讀檔,就能完成不少工作。Sourcebot 在較難的 SWE-bench Verified 任務上表現優於基線,同時成本更低,顯示索引化的文字與符號查詢在需要精確定位的場景中有實際價值。但在較簡單的 SWE-bench Lite 任務上,額外加入檢索層通常只帶來開銷,並未穩定提升結果。換句話說,當問題本身已經足夠明確,代理用最基本的檔案操作就能找到答案時,檢索層反而可能增加工具呼叫次數與上下文載入量。另一個測試集 CodeScaleBench 則呈現不同模式:當問題描述模糊、需要把不明確的需求對應到實作細節時,語義檢索更能發揮作用,因為它不依賴關鍵字完全匹配,而是根据概念相似度找出可能相關的程式碼。
這組結果帶出的第一個訊息,是檢索方法應該依任務特徵選擇,而不是把各種檢索方案視為可互換的萬靈丹。結構化程式碼搜尋適合目標明確的任務,例如「找出某個符號的定義」或「誰引用了這個函式」;語義檢索則適合需求尚不明確、需要跨檔案理解意圖的場景。第二個訊息與工具設計有關。報告指出,代理在實際操作時經常偏好開發者熟悉的動作,例如搜尋文字、讀取檔案、定位符號,而不是需要額外驗證的高階抽象工具。當一個工具回傳的結果需要代理再花步驟確認其正確性時,代理往往會退回較原始但可預測的操作。這意味著檢索工具的介面設計、回傳格式與可驗證性,會直接影響代理願不願意使用它,以及使用後能否真正減少探索成本。
在技術解讀之外,這項研究也引發了兩個層次的討論。Siddharth Vaithinathan 在 LinkedIn 上提出一個更廣的架構問題:編程代理是否只該理解程式碼,還是也該理解產生這些程式碼的組織?他認為,單靠倉庫索引無法捕捉架構決策背後的原因、當初的限制條件,以及過去事故帶給團隊的教訓。若代理只知道程式碼長什麼樣子,卻不知道為什麼會這樣設計,它在提出修改建議時就可能忽略歷史脈絡。他建議把代理的知識範圍從程式碼與文件,擴展到架構、約束、決策、決策理由、事故與結果。這樣的上下文能讓代理在動工前先評估既有設計選擇,對於那些深受歷史運維經驗影響的系統尤其重要。另一方面,Tarun Bhargava 則對基準測試的解讀提出提醒:當評估只使用有限子集,且求解模型本身具有機率性時,成本與準確率的數字需要多次重複執行同一設定,才能看出變異程度。單一輪的結果不宜過度解讀。
就實務建議而言,JioHotstar 團隊並未宣稱找到通用最佳解,而是提出一套組合策略。檔案系統工具應保留為基線,因為它在明確任務上成本低且行為可預測;結構化搜尋適合具體、以程式碼為中心的問題;語義索引則保留給模糊或跨領域的需求。團隊也強調,除了任務準確率,還應該測量代理的工具使用軌跡,也就是觀察代理在過程中呼叫了哪些工具、花了多少輪次、是否減少了不必要的探索。只有把準確率與行為軌跡一起看,才能判斷檢索層究竟解決了問題,還是只是把成本從一種形式轉移到另一種形式。這項評估的限制也值得注意:測試使用 SWE-bench 與 CodeScaleBench 的子集,結果受子集選擇影響;求解模型固定為 Claude Sonnet,不同模型對工具描述與回傳格式的適應力可能不同;自訂問答測試則綁定 JioHotstar 自家程式碼庫的特性。因此,這些發現更適合被理解為方法論示範與方向指引,而非可直接套用到所有團隊的固定結論。真正的啟示在於,檢索能力必須與任務性質、代理的導航方式以及工具的可驗證性一起設計,單獨比較某一種索引技術的優劣,往往無法回答代理在真實程式碼庫中是否變得更有效率。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。