基因體資料的規模與查詢難題
近年基因體定序成本下降,累積的變異資料量卻快速膨脹。對研究者與臨床單位來說,真正的挑戰往往不是產生資料,而是如何在不搬動龐大原始檔案的前提下,仍能回答跨族群的遺傳查詢。傳統做法是把各地的變異資料集中複製到同一個資料庫,再建立索引供查詢。這種集中式架構會帶來三個問題:儲存與傳輸成本、資料擁有權與法規限制,以及資料更新後需要重新同步。
InfoQ 報導指出,澳洲聯邦科學與工業研究組織(CSIRO)發展出的 Serverless Beacon,簡稱 sBeacon,正是針對這個問題提出的無伺服器架構。它讓查詢可以在原始儲存位置進行,不需要把大量基因體資料複製到中央資料庫。sBeacon 是 Global Alliance for Genomics and Health(GA4GH)Beacon 標準的一種實作。GA4GH 是推動基因體資料互通與負責任分享的國際聯盟,Beacon 則是其中一套查詢介面規範,讓不同機構能以標準化方式回答「某個基因位置是否存在特定變異」這類問題。
把基因體資料與搜尋用中介資料拆開
sBeacon 的核心設計,是把基因體資料本身與用來搜尋的中介資料(metadata)分開存放。變異呼叫格式(Variant Call Format,VCF)檔案留在 Amazon S3 物件儲存中,維持原本的位置與格式。VCF 是記錄基因體變異的常見文字格式,內容包含樣本在特定位置的基因型與品質資訊。至於疾病狀態、年齡、地理位置等可供篩選的資訊,則另外建立索引。這種分離讓系統不必為了查詢而改寫或複製 VCF,也讓 metadata 的更新可以獨立進行。
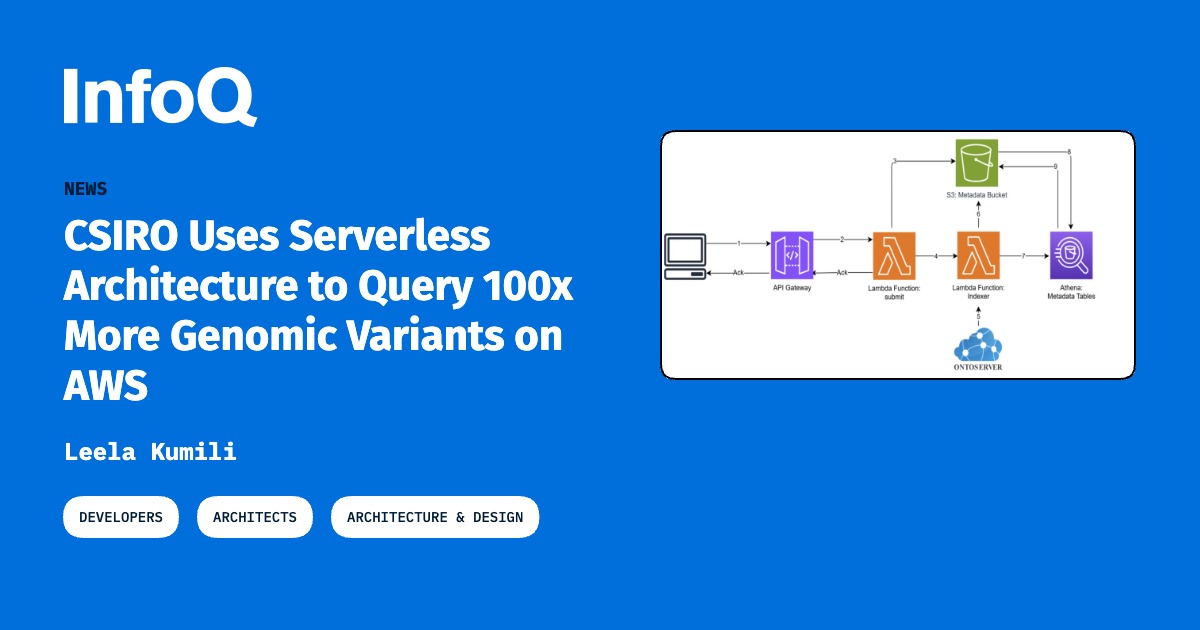
整體架構以 Amazon S3、AWS Lambda、Amazon Athena 與 Amazon DynamoDB 組成。DynamoDB 是可水平擴展的 NoSQL 鍵值與文件資料庫,常用於存放需要低延遲存取的索引或查詢狀態。在資料上架(onboarding)階段,sBeacon 會為 metadata 建立索引與 Amazon Athena 資料表。Athena 是 AWS 上的互動式查詢服務,能直接對 S3 中的資料執行 SQL 查詢,適合這種不想另外搬資料的情境。除了基因體資料,表型描述常需要受控詞彙,這部分由 CSIRO 自行開發的 Ontoserver 處理。Ontoserver 是一套術語伺服器,負責管理與提供標準化的本體論詞彙。透過它,查詢可以同時結合基因體變異與臨床或表型條件,而不是只比對單一基因位置。
查詢流程與 byte range 讀取
當查詢請求進來,Amazon API Gateway 會把請求路由到 AWS Lambda 函式。Lambda 是事件驅動的無伺服器運算服務,只在有請求時執行,適合這種難以預測流量、且單次查詢工作明確的場景。函式會先判斷哪些資料集與基因體區域和查詢相關,再交給變異查詢模組處理。
這個模組使用 bcftools 及其底層的 htslib 函式庫。bcftools 是處理 VCF 與 BCF 檔案的常用工具,htslib 則提供讀寫這些格式的底層能力。特別的是,sBeacon 透過 HTTP byte range 請求,只抓取 VCF 檔案中對應目標區域的位元組範圍,而不是下載整個檔案。HTTP byte range 是 HTTP 協定中只取部分內容的機制,伺服器可依指定範圍回傳片段。如此一來,即使 VCF 檔案很大,讀取特定基因體區域時仍只需傳輸必要資料。查詢結果最後會被彙整,並透過 Beacon API 回傳。
CSIRO 生物資訊產品解決方案架構師 Anuradha Wickramarachchi 特別點出壓縮的重要性。他表示,團隊謹慎處理的一個關鍵考量,是讓資料維持在壓縮程度最高的形式,而能在壓縮狀態下直接查詢,帶來很大好處。這也解釋了為什麼架構選擇保留原始壓縮 VCF,而不是先解壓或轉存到另一個資料庫。
實測結果
CSIRO 以 1000 Genomes Project 的第一號染色體進行評估。該資料集包含 2,504 個樣本,壓縮後的 VCF 檔案大小為 1.1 GB。在這個規模下,資料上架只花了 18 秒。一次涵蓋 10,000 個鹼基對的查詢,平均回應時間為 1.52 秒,估計運算成本約為 0.00013 美元。更值得注意的是延遲表現:當符合條件的變異數從 4 個增加到 400 個時,查詢延遲大致維持穩定。這表示系統的瓶頸主要不在結果數量,而在於能否有效率地取得對應的檔案區段。
這套架構並非突然出現。sBeacon 建立在先前發表於 Nature Biotechnology 的研究之上,該研究報告可支援最多 4,000 萬名個體與 30 億個基因體位置。早期的 Beacon 工作描述的是聯邦式模型(federated model),也就是各機構保留自己的基因體資料控制權,同時對外提供標準化查詢介面,查詢再分散到各資料源執行。GA4GH 的協定本身刻意不指定底層儲存技術,讓各實作能依環境選擇合適的基礎設施。2026 年的這個實作,則以雲端服務延伸該模型,提供具彈性的查詢執行能力,同時讓基因體檔案留在物件儲存中。
影響與限制
從實務角度來看,sBeacon 的價值在於降低跨機構基因體查詢的門檻。資料擁有者不必把敏感或龐大的原始資料交出,只要部署一套符合 Beacon 標準的查詢端點,就能參與聯合查詢。對於受到法規限制、或資料量太大難以集中複製的情境,這種模式特別有吸引力。無伺服器與物件儲存的組合,也讓成本更貼近實際使用量,而不是預先為尖峰流量配置固定資源。
不過,這樣的設計也有其前提與限制。系統高度依賴雲端服務,特別是 S3、Lambda、Athena 與 DynamoDB,若要移植到其他環境,需要對應的服務與調整。查詢效能仰賴 VCF 檔案的可分段讀取能力,以及資料是否維持適當的壓縮與索引;若資料格式或排列方式不合適,byte range 讀取的效益就會下降。此外,metadata 與本體論詞彙的品質,直接決定結合表型條件的查詢能否準確。聯邦式模型雖然保留了資料控制權,但也意味著整體查詢效能會受各資料源網路與回應速度影響,並非單一系統能完全控制。
整體而言,這項工作展示了一種務實路線:不把基因體資料搬進中央資料庫,而是讓運算靠近資料、只讀取必要片段,並以標準化介面串接分散的資料來源。對於基因體資料持續累積、卻又必須兼顧主權與成本的領域來說,這是一個值得關注的架構方向。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。