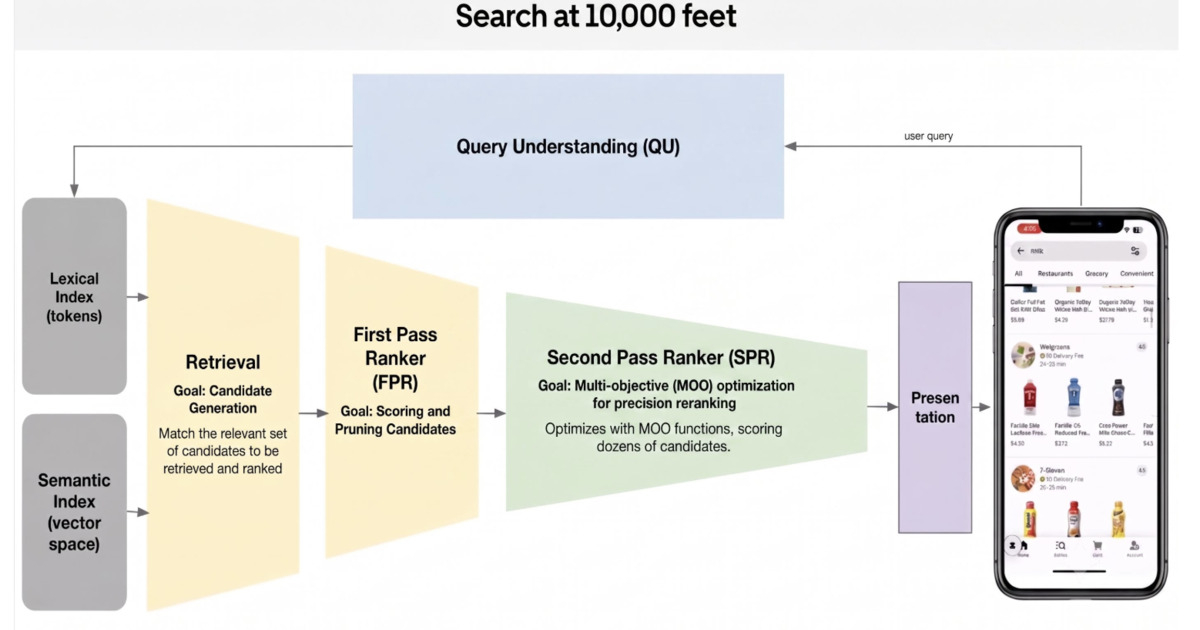
Uber 近期公開了 Uber Eats 搜尋系統的大規模改造細節,宣稱端到端搜尋延遲降低 50%。這項成果並非來自單一的架構翻新,而是橫跨檢索、特徵補齊、排序、廣告、前端呈現與基礎設施等多個層面的累積優化。根據 InfoQ 的報導,Uber 在過程中還導入了 agentic coding workflow,也就是由具備自主執行能力的 AI 代理協助找出候選優化點、建立效能基準並驗證改動效果,顯示 AI 輔助工程已開始進入大型效能調校工作的實務流程。
背景與問題
這次改造的起點其實是一個指標上的轉變。過去 Uber 主要以後端 API 回應時間衡量搜尋效能,但這個數字並不直接等於使用者的實際體驗。Uber 改為追蹤 Above-the-Fold completion,也就是從發出請求到第一屏搜尋結果完整渲染出圖片所需的時間。這個定義把網路傳輸、前端渲染、圖片載入等使用者真正感受到的延遲納入衡量範圍,使優化方向與體驗目標對齊。在這個新指標下,團隊發現舊架構存在大量隱性浪費,例如在排序之前就先為數萬筆候選項目補齊完整特徵資料,但其中許多項目最終會被排序階段丟棄,等於做了一大堆白工。
核心內容與技術做法
在檢索與資料補齊層面,Uber 移除了價值不高的檢索策略,省下約 120 毫秒;改用產品層級的 embedding(將商品轉換為向量表示以支援語意檢索的技術)取代逐筆資料查詢,使查詢次數減少超過 100 倍,再省下約 50 毫秒。接著將排序所需的特徵補齊與前端呈現所需的資料分開處理,避免不必要的資料載入,再降低超過 100 毫秒;此外透過移除元件間的相依關係省下 35 毫秒,並以 request hedging(同時向多個後端副本發送請求、取最先回應者以降低尾端延遲的技術)再省 40 毫秒。
呈現層方面,Uber 引入分頁搭配伺服器端快取,縮小首次回應的資料量,並以非同步渲染讓各結果項目可以並行處理,合計讓 Above-the-Fold 延遲改善超過 200 毫秒。廣告路徑則重新設計為欄導向的出價資料結構、改為記憶體內存取並減少序列化開銷,降低約 130 毫秒。基礎設施層的細節包括平行編碼、縮小 embedding 體積、連線管理改善,以及針對 Go 語言調整資料結構以降低垃圾回收(garbage collection)帶來的暫停與額外負擔。
脈絡解讀與社群觀點
這次改造在工程社群引發不少討論。Anubhooti Nagar 將其中的效能挑戰概括為「重點不在於把事情做得更快,而在於做更少的工作、避免不必要的等待」,並認為 Uber 採用的 Measure、Identify、Fix、Validate 循環可以作為持續效能優化的範式。Pratik Dhanave 則強調成果來自漸進式優化而非單一的大架構變革,是「橫跨全端的一長串謹慎決策」。Vidya Pandey 進一步把方法歸納為三個原則:做更少的事、更早開始做事、移除不必要的相依關係,並指出 Uber 規劃中的 microbatching 與 AI 系統中用來減少處理階段間同步開銷的技巧有共通之處。
值得注意的是,這些優化建立在 Uber 既有的搜尋平台之上,該平台先前已公開使用 Apache Lucene 作為檢索引擎、以 Spark 進行索引建置、透過 Kafka 串流更新資料,並搭配分散式服務層。換言之,這次的 50% 改善是在成熟系統上透過細緻分析擠出來的,難度與參考價值都相當高。
影響與限制
Uber 正在探索的下一步包括端到端 microbatching、以產品為基礎的檢索、Zero Pass Ranking(跳過部分排序階段以降低延遲的設計),以及 HTTP multipart streaming(讓回應分段傳輸而非整批等待)。其中產品化搜尋的早期測試已顯示 p99 延遲降低超過 50%,microbatching 的目標則是讓各處理階段彼此重疊,不必等前一階段完整結束。
不過需要留意的是,文中所列的毫秒數改善彼此之間未必能簡單相加,部分效益可能存在重疊,而「端到端延遲降低 50%」是 Uber 自行回報的數字,並未附帶完整的測量環境、流量分佈與對照基準細節。此外,這類優化高度依賴 Uber Eats 特定的流量規模、廣告架構與平台成熟度,其做法中的原則可以借鏡,但具體數字與實作細節難以直接套用到規模或架構不同的系統上。即便如此,從「重新定義使用者有感指標」切入、再以量化循環逐項消除浪費的方法論,仍是這次案例最值得帶走的部分。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。