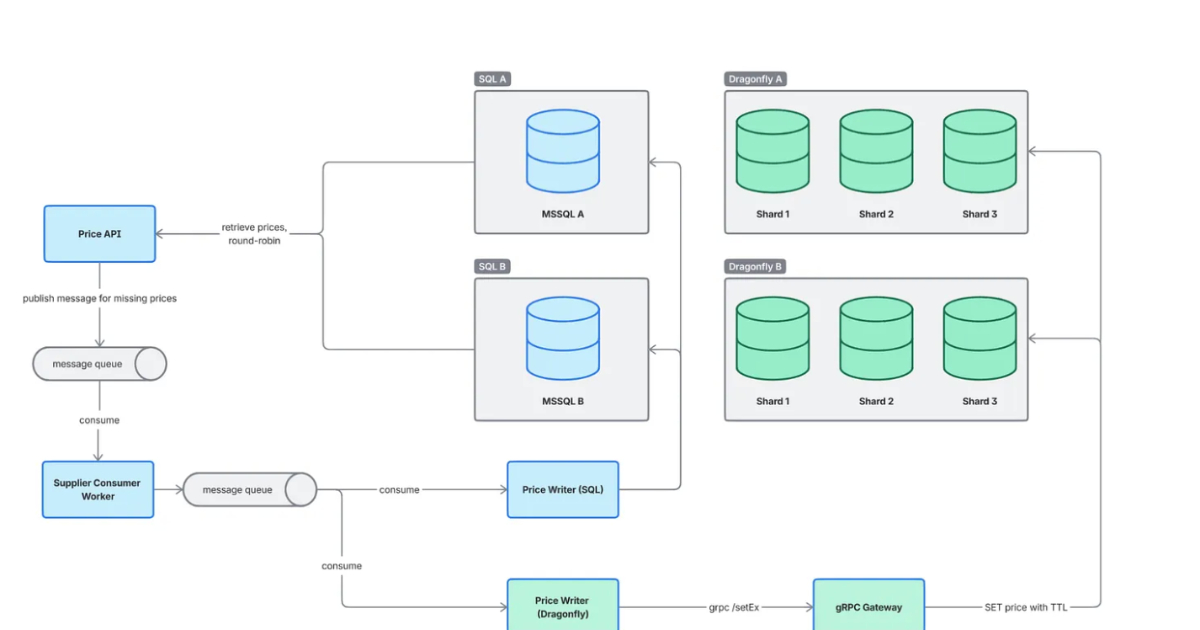
全球知名訂房平台 Agoda 面對龐大的即時價格數據處理需求,近期將其核心的酒店價格快取(Price Cache)系統從原本基於 Microsoft SQL Server 的分片架構,全面遷移至記憶體資料庫 DragonflyDB。這次轉型旨在解決讀寫壓力劇增、擴展成本過高以及維運複雜度增加的問題。
背景與面臨的挑戰
在遷移之前,Agoda 使用的是一個高度分片的 SQL Server 部署,總共將數據分散在 72 個分片(Shard)中。分片是一種將大型資料庫拆分成多個較小、可獨立運行的實體,以分擔單機壓力並提升併發處理能力的技術。然而,這種架構在面對快速增長的流量時顯露出明顯的侷限性。
首先,擴展成本極高且過程繁瑣。每當需要增加容量時,工程團隊必須按照預定義的硬體增量進行擴充,並手動執行分片重新映射(Shard Remapping)與數據遷移。即便在 2024 年初將硬體容量翻倍,但在不到一年的時間內,系統再次逼近性能極限。其次,由於快取中包含大量具有時效性的供應商價格數據,團隊必須額外開發一套清理流程來刪除過期資料,增加了系統的複雜度。
核心技術方案:引入 DragonflyDB
為了尋找更具成本效益且易於擴展的方案,Agoda 選擇了 DragonflyDB。這是一款高性能的記憶體資料庫(In-memory Datastore),其核心特點在於採用了共享無狀態(Shared-nothing)的多線程架構,能更有效地利用現代多核心 CPU 的運算能力,且與 Redis 協議完全相容。
Agoda 選擇 DragonflyDB 的關鍵在於其能完美匹配價格快取的運作模式。該系統高度依賴 MGET(一次獲取多個鍵值)與 SET(設置鍵值)這兩種操作。在正式導入前,Agoda 使用 memtier_benchmark 工具模擬生產環境中 1 比 6 的讀寫比,以及平均每次獲取 10 個鍵值的 MGET 操作,驗證其性能是否符合預期。
遷移過程與實作路徑
Agoda 並未採取一次性切換,而是採取循序漸進的遷移策略。起初,團隊部署了一個 1 TB 的 DragonflyDB 實例來處理熱數據,但隨著數據量增長,記憶體使用率接近 90% 的安全閾值。隨後,團隊將架構調整為每個集群包含三個分片的設計,最終將整個 1.5 TB 的數據集完整遷移至 DragonflyDB。
為了確保數據一致性,Agoda 在正式切換流量前引入了雙讀(Dual Reads)機制。系統在繼續由 SQL Server 提供正式回應的同時,會異步地從 DragonflyDB 獲取相同數據。團隊並非比對完整的價格內容,而是檢查供應商數量與數據長度,並透過 Prometheus(一種開源監控與警報系統)將比對結果視覺化。當數據一致性達到 99.9% 以上後,才透過 A/B 測試逐步將客戶流量切換至新系統。
性能提升與高可用設計
遷移完成後,Agoda 的價格快取表現出顯著的性能提升。在處理每秒 30 萬次讀取與 150 萬次寫入的壓力下,P99 讀取延遲(指 99% 的請求在該時間內完成)縮短至約 8 毫秒,較原先 SQL Server 架構提升了約 8 倍。
在可用性方面,Agoda 部署了 A 與 B 兩個獨立的 DragonflyDB 集群。為了避免依賴單一的中央協調器而產生單點故障,他們設計了一套去中心化的失效檢測機制。每個應用程序節點(Pod)會獨立觀察五分鐘內的快取命中率(Cache Hit Ratio)。若 A 與 B 集群的命中率出現 10% 的顯著差異,系統會自動判定該集群不可讀並觸發失效切換(Failover)。在模擬故障測試中,約 40 個應用節點在兩分鐘內自動完成切換,無需人工干預。
影響與實務意義
這次從傳統關聯式資料庫分片轉向現代記憶體資料庫的嘗試,為處理極大規模即時數據提供了參考。Agoda 不僅大幅降低了讀取延遲,更將原本僵化的硬體擴展模式轉變為靈活的集群擴展模式。同時,利用 DragonflyDB 內建的鍵值過期機制,徹底取代了原先繁瑣的數據清理流程,降低了維運壓力。
然而,這種方案的限制在於對記憶體的強依賴。由於所有數據必須儲存在記憶體中,當數據量達到 TB 等級時,對硬體成本的管控與記憶體碎片化管理將成為後續維運的重點。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。