OpenAI 與 Ligo 為何要做這個評測
2026 年 11 月 6 日,OpenAI 公布 BioBasicsBench,這是與專注酵素設計的生技公司 Ligo 共同開發的評測基準,用來衡量 AI 代理是否能處理濕實驗室中每天都會遇到的原始實驗證據。所謂濕實驗室,是實際操作生物樣品、跑凝膠、培養細胞、接菌、顯微觀察與使用儀器的環境;那裡的真實資料通常不是論文裡整理好的漂亮圖表,而是失敗的實驗、模糊的影像、彼此衝突的觀察,以及需要追查的對照組問題。OpenAI 指出,既有評測常圍繞論文精選圖表與影像,較難涵蓋這種模糊性與排錯需求,因此新基準的目標是檢驗代理能否解讀原始資料、找出錯誤,並在證據不足時承認不能下結論。這件事的重要性在於,誤讀一張影像或忽略對照組問題,可能讓科學家做出錯誤判斷,並把時間投入無法回答問題的實驗。
BioBasicsBench 的任務與資料長什麼樣
BioBasicsBench 共 100 項任務,分布於五類日常工作:蛋白質方法、影像與流式細胞分析、定量與分析法、核酸方法,以及分子選殖。任務難度從讀出凝膠中 DNA 樣本的分子量,到完整分析一組測定資料都有,但都屬於濕實驗室科學家應能可靠完成的例行工作。輸入保留科學家實際面對的證據形式,包括凝膠與墨點影像、培養皿照片、顯微鏡影像堆疊、定序讀段、盤式讀取器匯出檔與操作影片。來源列出的資料類型包含 31 項凝膠與墨點、27 項流程與筆記、20 項表格與儀器匯出、18 項實驗台與器材照片、14 項顯微影像、13 項儀器螢幕與圖表、12 項定序檔案、7 項流程影片與 7 項培養皿菌落;另有 21 項參考表作為輔助材料。這些類別可以重疊,參考表屬於支援資料,不應把各項數字直接相加當成任務總數。
任務由科學家使用自身實驗資料建立,每題都搭配專家撰寫的評分規準。每道題目經過三層審查:先由未參與撰寫的 Ligo 科學家內審,再由實際在濕實驗室工作的博士級科學家外審,最後回到內部複審。審查者會檢查題目、實驗證據、評分規準、作者註記與一次已評分的模型作答。代理需要回傳結構化答案,包含題目要求的結論、測量值或建議,並在需要時提供支持推理。答案依照評分規準中的個別條件給分,因此能區分「結論正確」與「分析只對了一部分」。多數任務同時測試多種能力,包括生物知識、影像與其他資料的解讀、錯誤偵測,以及對實驗流程的理解。
模型成績與多模態能力
OpenAI 在 BioBasicsBench 上評估七個模型:GPT‑5.2、GPT‑5.4、GPT‑5.5、GPT‑5.6 Sol、GPT‑6.1 Sol、GPT‑6 Luna 與 GPT‑6 Astra。評估涵蓋 37 種模型與推理努力設定,每個設定對 100 項任務各嘗試五次,總計 18,500 個結果。主要指標是平均得分,也就是把任務分數表示為可得評分上限的百分比;誤差棒則用整題重抽樣計算 95% 信賴區間,並保留每題五次嘗試的組合。在 xhigh 推理設定下,GPT‑6 Astra 平均得到 66.7%,信賴區間 60.3–73.1%;GPT‑6.1 Sol 為 62.0%;GPT‑5.6 Sol 為 43.8%,信賴區間 37.6–50.0%;GPT‑6 Luna 為 38.3%;GPT‑5.5 為 35.4%;GPT‑5.4 為 33.2%;GPT‑5.2 為 31.2%。Astra 每題平均輸出 4,704 個 token,Sol 則為 9,099 個。OpenAI 表示,Astra 即使在較低推理努力下也明顯優於 GPT‑5.6 Sol,並推測更強的原生多模態能力可能是改善日常濕實驗室分析的關鍵。
從判讀極限到控制組:Astra 的進步案例
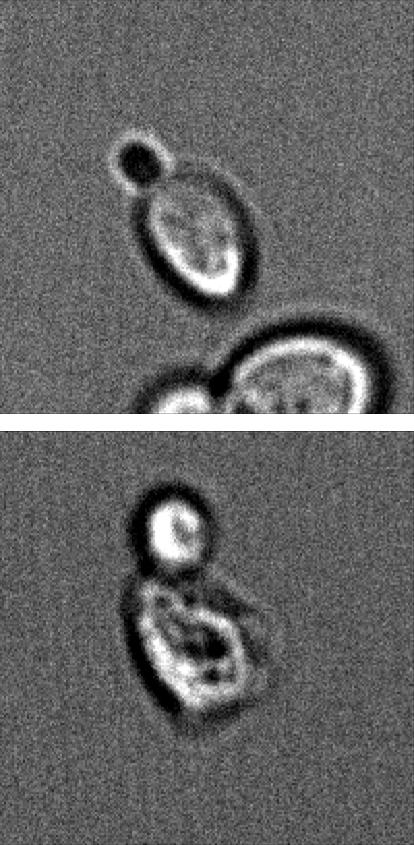
Astra 的改善首先表現在「知道資料不能證明什麼」。某題中,GPT‑5.6 Sol 依死亡細胞染劑訊號把細胞判為死亡;但偵測器也可能接收到第二種染劑的光,單靠亮度不足以支持結論。Astra 辨識出這個模糊性,要求更好的對照組來分離訊號。來源說明,同一批細胞的明場、SYTOX 標記 470–540 nm 與 FUN‑1 green 525–580 nm 三個通道在 525–540 nm 有重疊偵測窗,干擾量未被測量;各通道又以各自線性強度尺度顯示,因此不能跨通道比較亮度。
第二個案例是分子選殖。GPT‑5.6 Sol 看到陰性控制培養皿沒有菌落,便據此下結論;Astra 注意到培養皿邊緣標籤寫著「LB Kan50」,代表 kanamycin,與實驗使用的 ampicillin 不同,因此正確拒絕把它當成可靠控制組。第三個案例是一系列顯微影像中細胞忽明忽暗、看似消失;GPT‑5.6 Sol 尋找生物學解釋,Astra 則認出這是 z‑stack,也就是在不同深度拍攝的影像堆疊,細胞只是隨焦距改變而進出景深。這些例子顯示,多模態細節、控制組與實驗脈絡必須一起被納入判讀。
高分背後仍存在的失誤模式
不過,較高分數還不等於能在實驗室做出可靠判斷。來源列出 Astra 仍會犯的錯。首先,它可能讓熟悉假設壓過對照組支持的解釋:在菌落 PCR 範例中,Astra 能分辨兩組菌落條帶,卻假設較大的 PCR 產物就代表選殖成功,因而提議 lanes 4、6、7、8;參考答案透過對照比較選的是 lanes 5、9、10。lane 3 只有原始質體 PCR,提供舊質體參考位置;lane 2 同時含兩種模式,因為不完全組裝會留下舊模板或骨幹與新產物並存,菌落可能帶有舊或新質體。Astra 的視覺分組正確,但附加在兩組上的實驗身分與參考答案相反,若照此選菌,下游純化可能得到錯誤質體。
其次,Astra 會忽略與偏好解釋衝突的資料。它結論液泡通常比周圍細胞暗,但同一張影像中也有較亮的液泡;焦距改變可以反轉對比,因此較暗例子不足以建立通則。Astra 雖檢查多個區域並提到對比會隨焦距變化,最後仍偏重它認為對焦較好的細胞,只保留暗液泡描述。第三,在例行菌落計數中,Astra 的計數標記未必對應單一菌落:它無法解析相鄰菌落、漏掉可見菌落,也會把空白培養基算成菌落,最後相對基準參考約多算 12%。在塗盤體積與稀釋倍數固定時,這種高估會以相同比例膨脹對 DNA 導入效率的估計。
影響、限制與後續觀察
BioBasicsBench 的意義,在於把濕實驗室日常判讀變成可追蹤的改進目標:能否解讀原始實驗資料、檢查控制組,以及辨識某個結論其實沒有證據支持。若這些能力穩定進步,科學家可能少花時間排錯,把更多時間用於決定下一個值得做的實驗。OpenAI 也指出,追蹤這些能力有助理解其對生物安全與生物保全的意涵。限制同樣清楚:高分仍不代表模型可以獨立做出實驗室判斷,前面的案例已顯示假設、預期答案、標籤與正確的中間觀察,都可能無法引導出正確最終決策。此基準聚焦 100 項例行任務與答案評分,評的是分析與判讀,而不是實際動手操作或完整實驗流程,因此它適合作為能力量測與改進依據,不能被當成實驗室可靠作業的保證。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。