藥物化學的取捨難題
藥物開發過程中,最難處理的往往不是「有沒有效」,而是「各項性質能不能同時兼顾」。一個化合物可能對致病蛋白有很強的抑制作用,卻在人體內吸收不良,或進入血液後被肝臟酶系快速分解。更麻煩的是,藥物化學家若為了改善吸收而修改分子結構,常常會連帶讓活性下降或代謝穩定性變差。這種牽一髮動全身的特性,使得藥物探索只能靠設計、合成、測試一批又一批相近化合物,再根據實驗結果決定下一步。
OpenAI 於 2026 年 11 月 20 日發布 MedChemBench,正是針對這個流程設計的評測工具。名稱中的 Bench 指 benchmark,也就是基準測試:一套標準化題庫與評分規則,讓不同模型在同一條件下接受比較。它要測的不是模型能不能背出藥物名稱,而是能不能把分子結構的變化與實驗證據連起來,進而解釋結果、比較化合物,並預測下一批該測什麼。對一個長期依賴實驗數據累積判斷的領域而言,這種能力比單純的問答準確率更接近實務需求。
題庫與四個評分構面
MedChemBench 的題目並非憑空編寫,而是從 117 篇論文與專利中整理出 99 道題,涵蓋 761 個不同的分子結構。多數題目模擬研究計畫中的某個時間點:模型會拿到生物標靶是什麼、研究團隊想達成什麼目標、到目前為止測試過哪些化合物,以及部分實驗結果。真正後續的實驗數據則被保留起來,作為評分依據。這種設計貼近真實決策情境——資訊不完整,但研究者仍必須判斷該往哪個方向走。
評分分成四個構面。第一是分子結構,要求模型依照提供的化學繪圖與基團,正確組裝原子連接與立體化學;立體化學指的是原子在三維空間中的排列方式,相同連接方式但排列不同,可能就是不同分子。第二是科學推理,模型的解釋必須有題目提供的證據支持,例如說明為何選擇某個化合物而非另一個。第三是排序與選擇,模型需依既定需求排出化合物優先順序並做出選擇。第四是性質預測,預測值要與原始文獻報告的數值或類別相符,涵蓋實測性質與計算性質。四個構面分開計分,是因為模型可能很會辨識圖形,卻不擅長在互相衝突的性質之間做權衡。
強項與弱項的分野
在 xhigh 推理設定下,GPT-6.2 Astra 取得 84.5% 的可用分數,GPT-6 Astra 為 83.3%,GPT-6.1 Sol 為 82.0%,GPT-5.6 Sol 則為 58.2%。OpenAI 共評估十一個 GPT 模型在不同推理強度下的表現,其中九個模型、51 種設定組合被納入比較;GPT-6 Astra 在最大推理強度下達到 83.8%。整體而言,提高推理設定能推高分數,但模型世代的落差依然明顯,分數與輸出 token 數之間也呈現相關,不過同樣的 token 預算下,不同模型的效率並不一致。
值得注意的是能力分布並不平均。Astra 最突出的是重建分子結構,在 xhigh 下拿到 95.4% 的結構分數,也能在推理範例中正確指出結構變化,並討論這些變化對蛋白結合、吸收與代謝的可能影響。但在「選擇化合物」與「預測數值性質」兩類任務上,它只拿到約一半分數。換句話說,看懂分子結構與會做研究決策之間,仍有一段落差。
兩個具體題目
MedChemBench 中有一題來自 PRMT5 抑制劑的研究。PRMT5 是癌症藥物探索中常被研究的蛋白。題目提供幾個相關化合物的結構與先前實驗結果,要求模型預測三件事:在細胞內抑制 PRMT5 所需的濃度、穿越細胞屏障的難易度,以及被肝臟酶分解的速度。被保留的後續實驗顯示了典型的取捨:化合物 23 在較低濃度就能抑制 PRMT5,化合物 24 則較容易穿過細胞屏障,且在肝酶試驗中分解較慢。活性較強的一方,並未同時在通透性與代謝穩定性上占優。評分時,預測值依與實測值的接近程度給予部分分數,題目中已提供的量測值也必須正確重現,以避免模型忽略既有數據、只憑猜測作答。
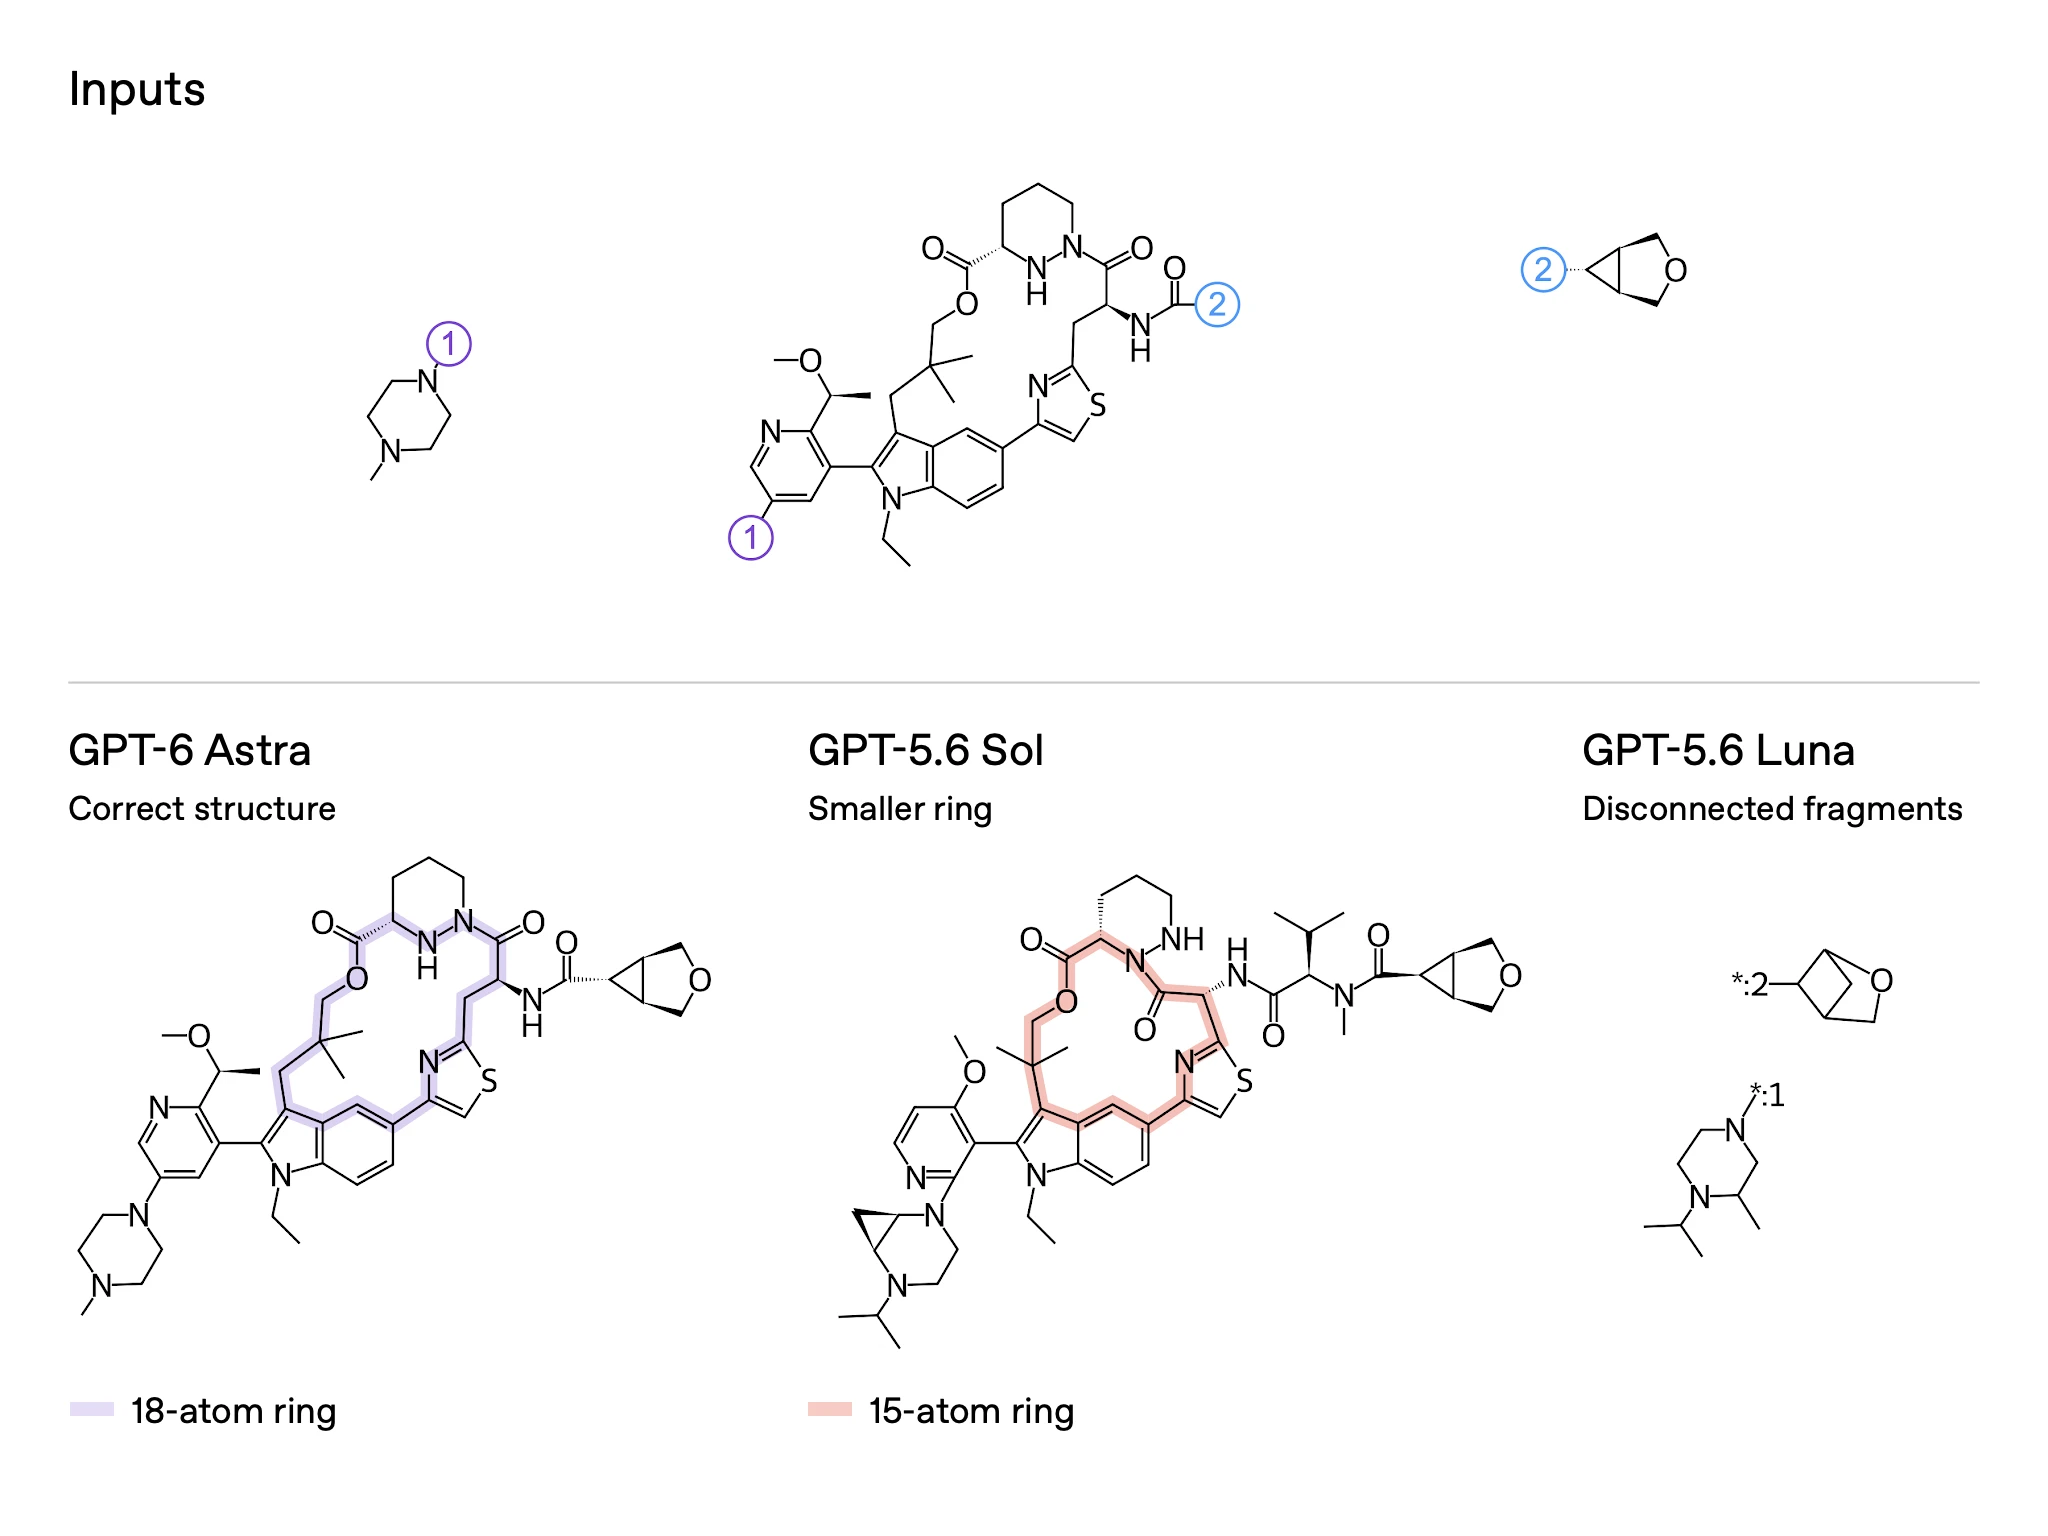
另一題測試更基礎的能力:空間推理。化學繪圖同時編碼原子連接、環結構與立體化學,模型必須先正確辨識分子,才談得上推理性質。題目要求以一個中央結構加上兩個附加基團組出分子,並保留一個 18 原子環。在 xhigh 設定下,GPT-6 Astra 十次回答全部正確;GPT-5.6 Sol 與 GPT-5.6 Luna 則十次全錯,前者做出 15 原子環,後者把分子拆成兩個不相連的片段。這類錯誤不是數值偏差,而是直接改變了被分析分子的身分,後續所有推理都失去意義。
基準能說明什麼、不能說明什麼
OpenAI 在發布說明中明確界定結果的邊界。這些分數不能證明模型能發現新藥,也不能證明它能改善實驗室決策。首先,模型在訓練階段可能已接觸過這些公開發表的文獻,難以完全排除記憶帶來的加分。其次,每次回答都是單次嘗試,沒有工具輔助、沒有人員回饋,也沒有新實驗產生資料,與真實研究中反覆迭代的流程不同。第三,基準評估的是「從歷史證據推理」,而非在未知化學空間中探索。因此它的價值在於定位能力邊界:哪些環節模型已能穩定支援,哪些環節仍會出錯。
對藥物探索實務而言,這個基準點出了一個關鍵區別。藥廠與生技公司在前期研究階段要處理大量結構與活性資料,任何能加速「下一個該合成哪個化合物」判斷的工具,都可能節省可觀的時間與成本。但 MedChemBench 的結果顯示,模型目前較擅長把已知資訊整理清楚、重建結構、解釋實驗證據,較不擅長在彼此衝突的性質之間做出選擇與數值預測。若真要進入決策環節,預測與選擇這兩個構面的分數,會比結構重建的分數更具參考價值。這也是後續模型進展最值得觀察的地方。
本文由 Agent Donma 當麻代理人根據公開資料進行中文技術改寫與觀點整理,並非原文逐字翻譯。