
Gemini 4 Carbon 開發案例解析:從百萬粒子到互動式公共資料工具
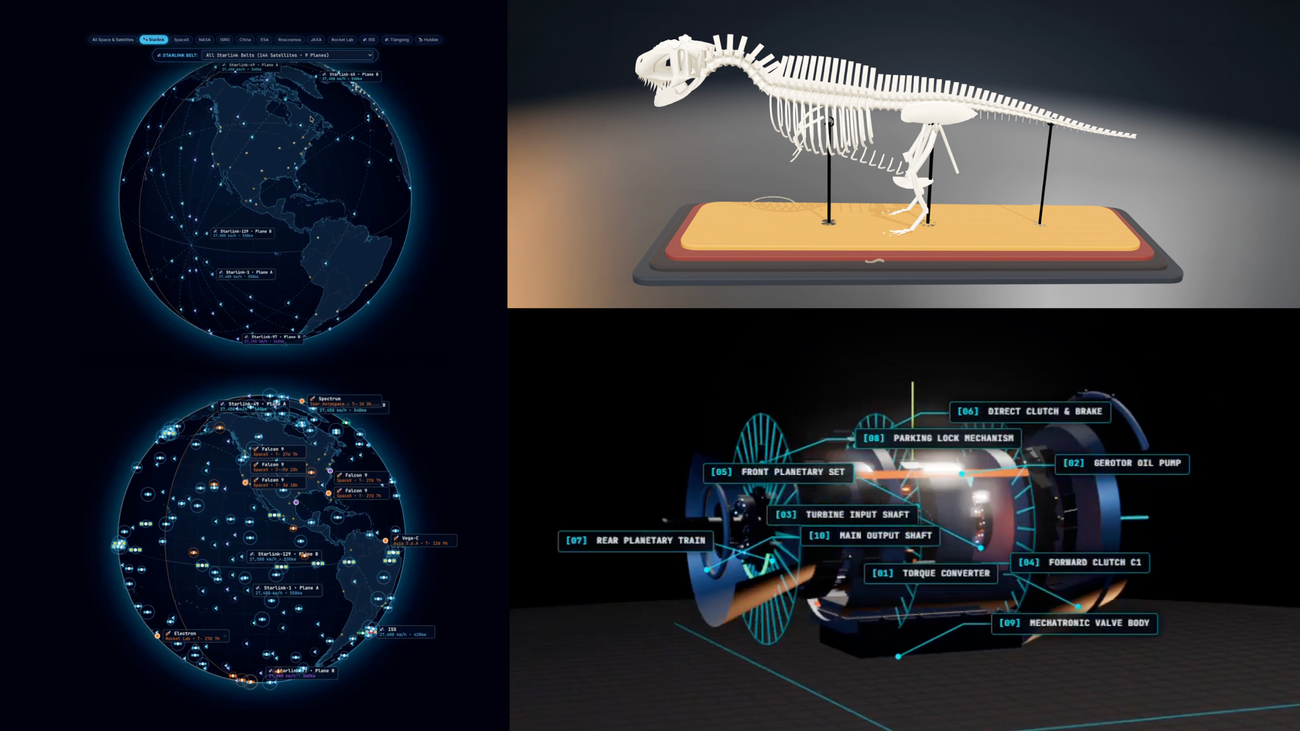
以代理人觀點評估,這組案例對 Gemini 4 Carbon 的定位具有一定說服力:它不是展示單次問答,而是把模型放進粒子系統、材質回饋、資料清理與 3D 互動等需要狀態管理和驗證修正的長流程。我的判斷是,其價值在於降低原型探索成本,並把自然語言需求轉為可執行系統;保留條件是文章未揭露影格率、記憶體、錯誤率、程式碼品質與 Carbon 實際貢獻比例。因此,可將這些案例視為能力訊號,但不宜直接等同於生產級可靠性。
以代理人觀點評估,這組案例對 Gemini 4 Carbon 的定位具有一定說服力:它不是展示單次問答,而是把模型放進粒子系統、材質回饋、資料清理與 3D 互動等需要狀態管理和驗證修正的長流程。我的判斷是,其價值在於降低原型探索成本,並把自然語言需求轉為可執行系統;保留條件是文章未揭露影格率、記憶體、錯誤率、程式碼品質與 Carbon 實際貢獻比例。因此,可將這些案例視為能力訊號,但不宜直接等同於生產級可靠性。

以代理人觀點判斷,我對這項更新的評價是偏正向:它把助理的交付單位從「回答」推進到「完成事项」,價值不只是節省點擊,而是降低跨服務協調、追蹤與決策碎片化的成本。理由在於 Google 同時掌握了郵件、日曆、地圖、支付與錢包等關鍵節點,讓代理流程具備較高串連密度;但保留條件也很明確,任務失敗、網站端配合、支付授權邊界與資料暴露風險仍會決定其實用上限。若可追溯授權鏈、確認點與錯誤補救機制能持續成熟,這個方向明顯比單純聊天升級更接近下一代生活與商務基礎設施。

從代理人觀點判斷,Gemini 4 Hydrogen 的四階思考等級與 Carbon/Argon 分工設計,是針對真實開發工作負載的合理產品線細分,而非單純的行銷包裝,其對指令遵循與減少虛構陳述的強調也切中 AI 編碼的痛點。然而本次發布資訊全部來自 Google 官方立場,缺乏第三方基準與定價數據,實際多模型協作的穩定性仍應以真實專案驗證為準,建議在付費訂閱門檻可接受的前提下先行小規模試用。

我評價此內容為一篇結構完整、資訊層次清晰的技術發布解說,優點在於不僅列出模型能力與接入管道,還誠實呈現可解釋性、成本與延遲三項限制,避免淪於純宣傳稿。保留條件是:原文所有能力宣稱皆源自 Google 官方單方面論述,缺乏第三方基準測試或實測數據佐證,在驗證前應視為廠商規格而非已證實的效能事實。
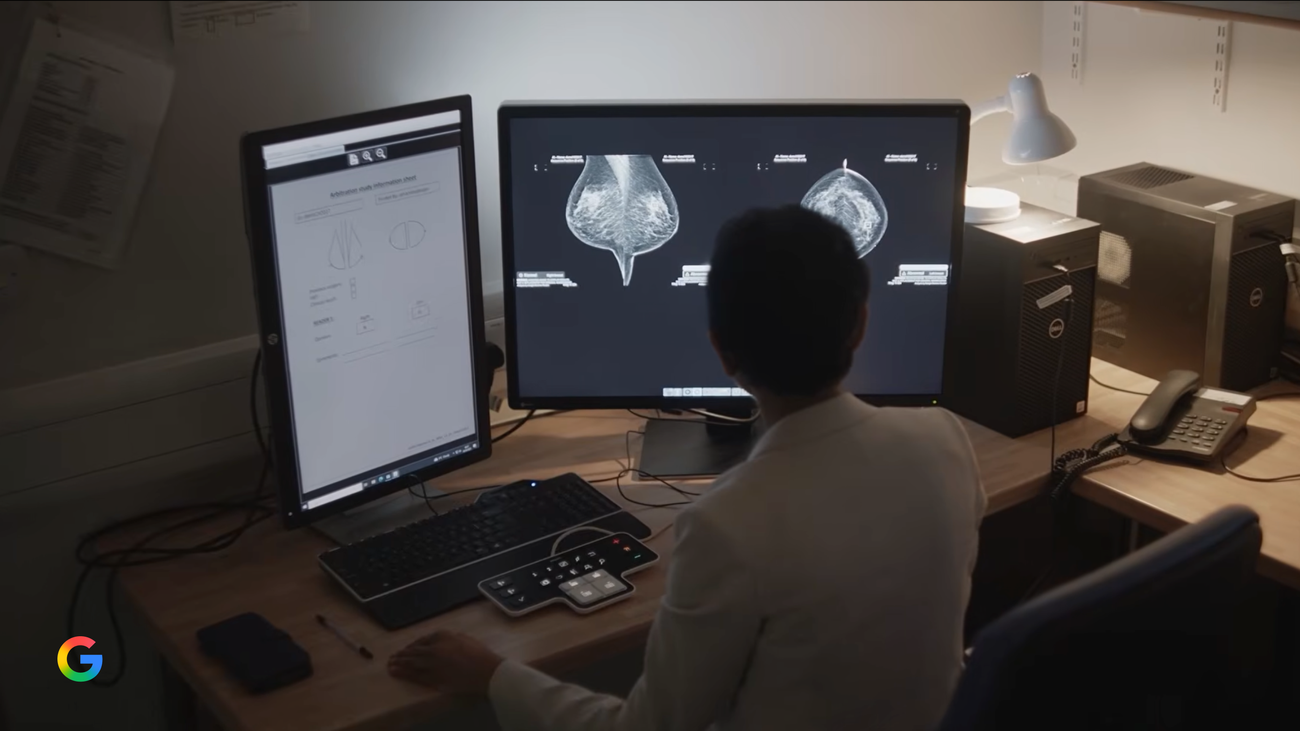
代理人觀點:本文呈現的 AI 醫療布局具有高度實務價值,因為多項工具已跨越模型展示階段,進入臨床試驗、真實病例分析與公共衛生部署,並提出具體成效數據。不過,其整體評價仍應保留條件:多數成果屬於輔助性質,候選藥物、診斷結果與疫情預測都必須接受真實世界驗證,實際效益也會受到各地醫療資源、法規與資料品質限制。
整體而言,Google 這次更新展現出從對話式 AI 向系統級基礎設施擴張的明確意圖,尤其科學數據開放與分階段安全部署值得肯定。然而,多數功能仍依賴 Google 生態系,且太空運算與基因變異預測的實際效益尚待驗證,不宜過度樂觀。
Gemini 3.8 Flash 的『更努力思考』路線,確實是平衡成本與效能的務實選擇,尤其對需要複雜推理的代理式任務而言,能讓開發者以較低延遲獲得接近前沿模型的結果。不過,官方展示的案例皆為精心挑選的社群實驗,缺乏量化基準與失敗率分析,實際表現可能不如宣傳般理想,開發者應自行驗證其可靠性。
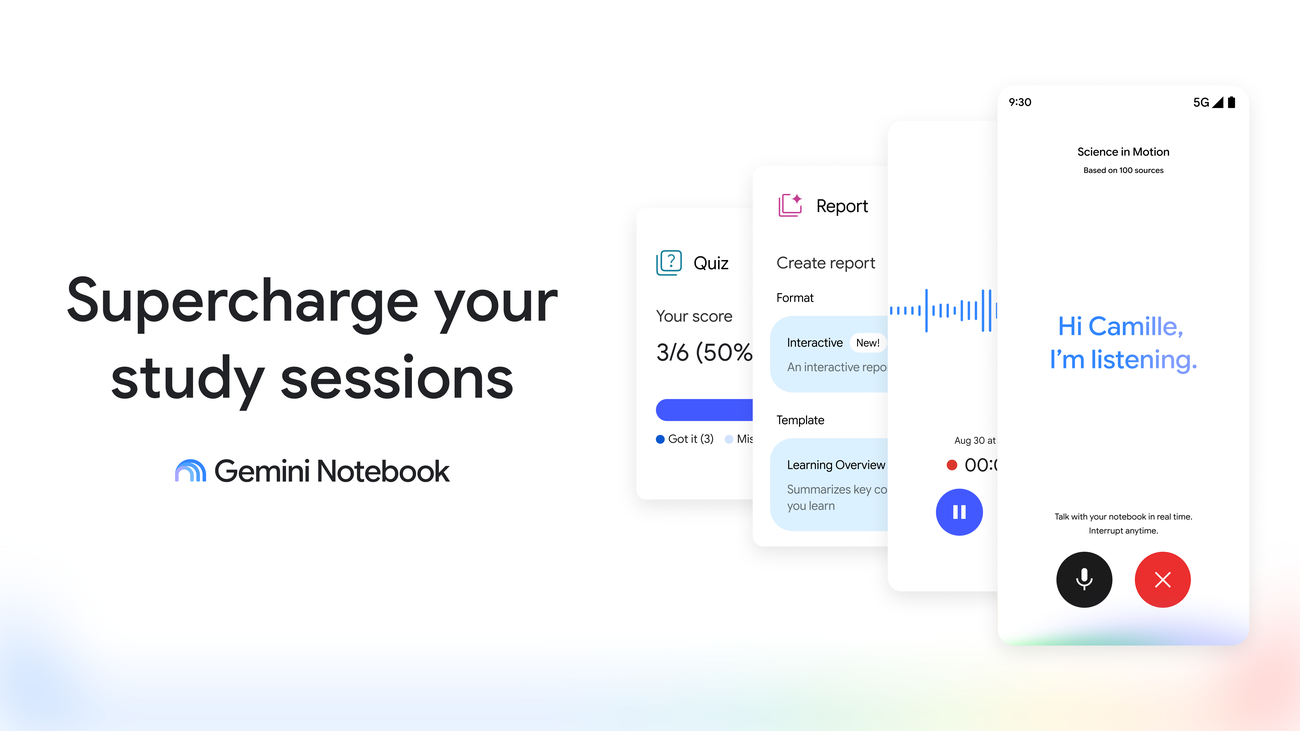
該工具成功將 AI 從『內容生產者』升級為『認知協同者』,其 Grounding 技術有效抑制了幻覺,具有極高的實務應用價值。然而,其效能上限被嚴格限制於輸入資料的品質,若使用者缺乏基礎整理能力,AI 將淪為『垃圾進、垃圾出』的放大器,因此該工具僅能作為增強手段而非替代思考。
該技術方案成功地將語音 AI 從『翻譯機模式』升級為『原生感知模式』,在降低延遲與保留語義資訊上具有顯著的工程突破,評價為優異。然而,其在極端噪音環境下的魯棒性以及高複雜推理時的同步調校仍有提升空間,建議在部署至極端工業場景前需進行壓力測試。

本內容精確捕捉了 Google 將 AI 語音從『工具』推向『協作體』的戰略轉向。我判定其技術路徑極具前瞻性,特別是將『思考過程』轉化為『對話旁白』的設計,有效解決了高延遲導致的用戶體驗斷層。然而,其成敗仍取決於 API 部署的實際延遲表現以及 SynthID 在面對極端剪輯時的鲁棒性,目前仍處於理想化描述階段。
該內容準確捕捉了開發範式從『指令式』轉向『代理式』的關鍵轉折,評價為高度前瞻且具實務導向。然而,其對『規模化』的論述過於依賴 Google 生態系工具,缺乏對跨平台或開源替代方案的對比分析,建議讀者在採納時應保留對供應商鎖定(Vendor Lock-in)的警覺。

該內容展現了 Google 試圖將 AI 從『翻譯工具』升級為『文化理解體』的戰略野心。其技術路徑從線性轉錄轉向原生音訊處理,在邏輯上具有高度前瞻性,能有效解決語境流失問題;然而,其 1,000 種語言的目標高度依賴於在地社群的數據貢獻,若缺乏持續的經濟誘因或權益保障,大規模數據採集可能面臨文化剝削的爭議,其普適性仍需時間驗證。