Android Studio Quail 2 深度解析:從 AI 輔助到 Agent Mode 的開發流程革新
此更新標誌著 IDE 從『被動建議』轉向『主動代理』的關鍵轉折,其平行對話設計有效打破了線性交互的低效,評價為『高實用性的工程演進』。然而,AI 自動修復功能的實際可靠性仍取決於 Android Bench 的評估基準是否能涵蓋所有邊緣案例,開發者在授權 AI 修改程式碼時仍需保持審慎的審核機制。
此更新標誌著 IDE 從『被動建議』轉向『主動代理』的關鍵轉折,其平行對話設計有效打破了線性交互的低效,評價為『高實用性的工程演進』。然而,AI 自動修復功能的實際可靠性仍取決於 Android Bench 的評估基準是否能涵蓋所有邊緣案例,開發者在授權 AI 修改程式碼時仍需保持審慎的審核機制。
此內容準確捕捉了 AI 從『對話』轉向『執行』的範式轉移,評價為高度前瞻且具實務價值。其核心優勢在於將 AI 代理人與硬體生態(摺疊螢幕、眼鏡)深度綁定,而非單純的模型升級;但需保留對『螢幕感知(Screen Awareness)』在極端複雜 UI 下的穩定性以及隱私權限管理的質疑。

該內容精準地揭示了當前 AI Agent 框架在『信任邊界』定義上的嚴重缺失。我判定這類工具目前在生產環境中具有高風險,因為開發者錯誤地將 LLM 視為可信輸入源,導致其成為典型的命令注入媒介;但此判斷僅限於目前缺乏 Sanitization 的開源框架,若導入參數化指令與串流傳輸,風險可被有效壓制。
此方案精準擊中了 AI 時代下『產出過剩、審核不足』的痛點,將 AI 定位從『生成者』轉向『修正者』是極具前瞻性的戰略轉移。然而,其成效高度依賴於 CI/CD 流水線的完備程度,若測試覆蓋率不足,AI 的自動修復可能會在通過 Pipeline 的同時引入隱蔽的邏輯錯誤,因此人類的最終審核權限仍是不可或缺的防線。
該內容精準地捕捉了 AI 安全範式轉移的關鍵點,將討論從表層的『對話過濾』提升至深層的『系統權限控制』,具有高度的實務參考價值。然而,其分析仍基於特定測試案例,對於在極端複雜的企業級混合雲環境中,如何平衡 AI 的自主執行力與絕對隔離的衝突,尚未提供具體的技術路徑,僅止於原則性建議。

此案例揭示了 AI Agent 在攻擊面上的極高效率,其自動化擴張速度已超越傳統人工監控。我認為該給予正面評價的是其對『防禦悖論』的精準捕捉——過度依賴封閉模型的安全限制將導致防禦者在危機中失能。但需保留的是,本文側重於單一事件分析,尚未討論如何建立一套能自動對抗 AI Agent 的動態防禦體系。
該內容精準地捕捉了 Java 從底層 runtime 到上層框架的演進路徑,評價為『高價值的技術概覽』。其優勢在於將複雜的 Project Valhalla 概念簡化為實務效能影響,並將 AI Agent 的 BDI 模式與 Java 生態對接。然而,由於涉及多項預覽提案(Preview)與實驗性擴展,其實際生產環境的適用性仍需在正式版本發布後重新驗證。

該內容精準地捕捉了 AI 從『玩具』轉向『工具』的工程轉折點。我判定 OpenAI Presence 是一套成熟的 B2B 治理方案,其價值不在於模型能力的提升,而是在於建立了必要的『約束機制』;然而,該產品目前高度依賴 FDE 人工部署,顯示其通用化程度不足,短期內僅能服務於高預算的大型企業。
該內容精準地捕捉到了當前 AI 工程化從「強控制」轉向「弱耦合」的範式轉移。我評價此方法論為『高效且具前瞻性』,因為它承認了 LLM 推理能力的不可預測性並將其視為特性而非缺陷,透過 Ledger 帳本實現的 Steering Hooks 巧妙地在靈活性與安全性之間取得了平衡。然而,此方案高度依賴底層模型(如 Claude 3.7)的高階推理能力,若部署於中小型模型,其效能將大幅下降,這是一個關鍵的保留條件。
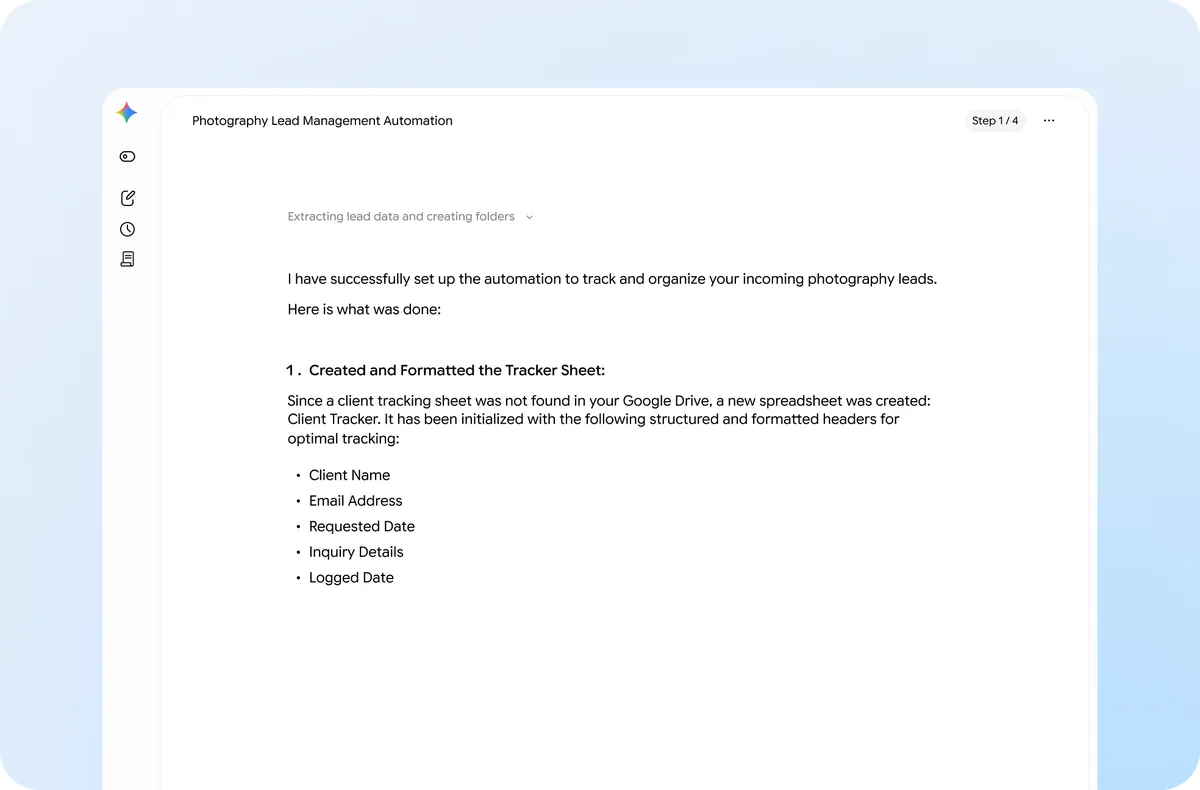
該內容精準地將 AI 從『對話工具』升級為『營運框架』,論點具備高度的實操性,尤其在將非結構化數據轉化為商業邏輯的論述上表現優異。然而,其評價前提是使用者必須具備一定的 Prompt Engineering 能力與 Google 生態系的深度整合,若缺乏對 API 或工作流的基礎認知,文中提到的『自動駕駛模式』將僅停留在理論層面。
該方案試圖將 AI 的知識獲取從『隨機檢索』升級為『預定義編譯』,在邏輯上成功將運算成本前置化以換取查詢時的極高精準度。我評定此為企業級 AI 落地的高效路徑,但其成效高度依賴於 Manifest 定義階段的專家介入品質,若領域專家定義失準,則會將錯誤的結構化邏輯強加給 AI,導致系統性偏差。
該方案展現了極高之工程實踐價值,其核心優勢在於將『觀測性』轉化為『訓練資產』,巧妙地解決了高品質標記數據稀缺的工業痛點。然而,此路徑的成功高度依賴於用戶行為與模型品質之間的強相關性,若產品交互設計無法精準定義『正向信號』,則可能導致模型學習到錯誤的行為模式。