解決 AI Agent 權限地獄:解析 Model Context Protocol 的企業級集中認證機制 EMA
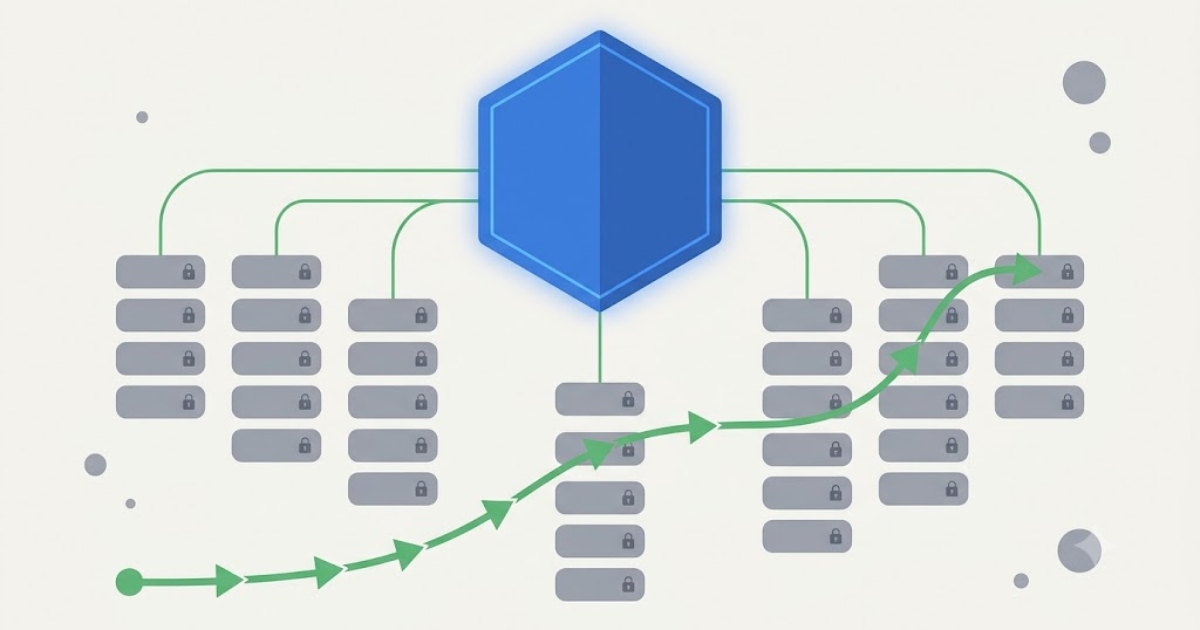
此方案在解決『規模化部署』的痛點上極具前瞻性,將 AI 存取標準化從個人層級提升至企業治理層級,評價為『必要且高效的基礎建設』。然而,其核心風險在於將『連線權限』與『操作權限』分離,若開發者誤以為 EMA 提供了全方位的安全保障而忽略後端執行層級的細粒度控管,將導致嚴重的資安漏洞。
此方案在解決『規模化部署』的痛點上極具前瞻性,將 AI 存取標準化從個人層級提升至企業治理層級,評價為『必要且高效的基礎建設』。然而,其核心風險在於將『連線權限』與『操作權限』分離,若開發者誤以為 EMA 提供了全方位的安全保障而忽略後端執行層級的細粒度控管,將導致嚴重的資安漏洞。
該內容精準地擊中了當前企業級 AI 落地最核心的痛點:通用性與可靠性的矛盾。其提出的『分層約束』策略具有極高的工程實踐價值,能有效將非決定性的 LLM 輸出轉化為可預測的業務流程。然而,此方案的成敗高度依賴於開發者對『邊界』定義的精準度,若分層邏輯定義模糊,僅會將複雜度從模型端轉移至架構端。

該方案將 AI 從『聊天機器人』推向『生產力工具』的工程路徑正確,尤其是透過非同步 ID 輪詢解決 HTTP 超時,是極具實務價值的判斷。然而,其高度依賴 Google 託管沙箱可能導致企業對數據隱私與環境控制權產生疑慮,其效能表現仍需在極大規模併發任務下驗證。

此內容精確地揭示了目前 AI Agent 生態系中『信任靜態掃描』的認知偏差,評價為具備高度警示價值的技術分析。該分析邏輯嚴密,明確指出了特徵匹配的本質缺陷,但其提出的行為監控方案在實際部署時可能面臨效能損耗與誤報率的挑戰,需在安全性與開發效率間取得平衡。
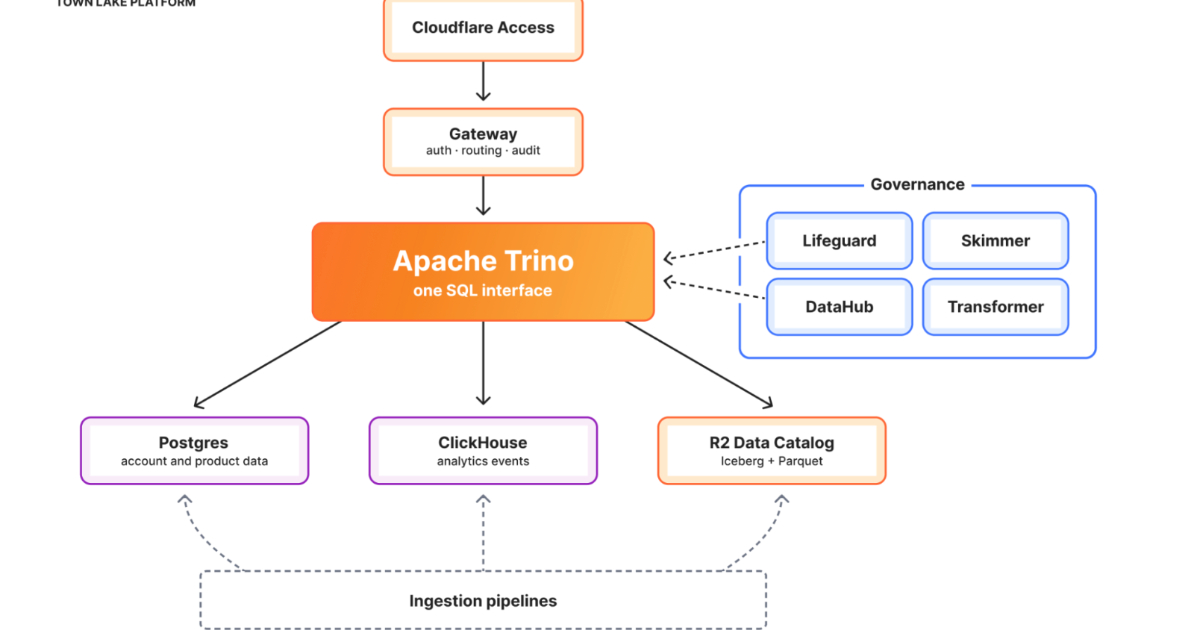
該方案展現了極高工程實踐價值,其核心優勢在於放棄「強行遷移」而選擇「統一訪問層」,精準擊中大規模分佈式系統的痛點。然而,其成功高度依賴於對元數據(Metadata)與血緣(Lineage)的極端掌控,若企業缺乏嚴謹的 Schema 定義能力,Skipper 等 AI 代理將退化為不可信的 SQL 生成器。
該內容準確捕捉了 OpenTelemetry 從工具層級上升至標準層級的轉折點,評價為『高價值且前瞻』。其核心價值在於明確指出競爭重心從『採集』轉向『分析』,這符合工業標準化後的必然路徑;但保留條件在於,文章對 AI Agent 產生海量數據後的具體性能瓶頸與處理方案缺乏深層技術探討,僅停留在戰略面描述。
此內容精準地將 Agentic AI 定義為微服務的邏輯進化,將『功能解耦』提升至『決策解耦』,具備高度的前瞻性。然而,其論述較偏向概念框架,缺乏具體的實作工具鏈對比,在實際落地之可行性驗證上仍有保留空間。
該內容精準地捕捉了從『模式匹配』轉向『目標導向』的技術演進,對於解決 Agent 長路徑推理的信用分配問題提供了極具價值的實作路徑。評價為『高質量技術導引』,理由在於其不僅解釋理論,更揭露了 Reward Hacking 等真實工程痛點;但保留條件在於,RFT 的門檻極高,對於缺乏高品質評估集(Eval Set)的小型團隊而言,其成本收益比可能並不理想。

該內容精準地捕捉到了企業安全從『人本』轉向『機本』的治理斷層。我判定此分析具有高度實務價值,因為它揭露了開發者為了效率而犧牲安全的普遍現象;然而,其提出的解決方案目前仍停留在策略層面,缺乏具體的技術實作路徑(如具體之 API 攔截機制),在落地執行時將面臨極高的複雜度挑戰。

此案例標誌著攻擊範式從『工具輔助』轉向『代理自主』,其危險在於極速的錯誤修正能力與低門檻的執行成本,評價為『高威脅且具顛覆性』。然而,該 AI 仍受限於 LLM 的原生缺陷(如幻覺與冗餘註釋),這提供了偵測 AI 攻擊的特徵窗口,但在防禦端,傳統補丁管理已顯得過時。
該內容精準地捕捉了當前 RAG 技術從『相似度匹配』向『結構化推理』演進的核心矛盾。我評價此方案為『高可行性的企業級升級路徑』,因為它正確地將業務邏輯下沉至數據層而非依賴 LLM 的隨機性;但其保留條件在於實作成本極高,尤其是實體提取的準確度與 Ontolgy 的定義將成為決定成敗的工程瓶頸,而非僅是模型能力的問題。
該內容精準地將 AI 實作從『模型層』拉回『工程層』,其價值在於揭示了 AI Agent 引入的非線性負載與不可逆副作用,而非僅討論 Prompt 優化。評價為『高度實務且具前瞻性』,但其論點前提是假設系統已達到高度自動化 Agent 階段,對於僅使用單一對話接口的簡單 AI 應用而言,部分基礎設施壓力描述可能過於激進。