
突破量化精度損失:Liquid AI 透過量化感知蒸餾提升 LFM2.5 邊緣端效能
此技術方案在『效能-品質』權衡上取得了極高水準的突破,將量化損失控制在 3% 內且提升了吞吐量,屬於極具實踐價值的工程優化。然而,其優勢建立在供應商端高昂的蒸餾訓練成本之上,這意味著該方案僅適用於擁有強大算力且追求極致終端體驗的模型開發商,而非一般中小規模的微調使用者。
此技術方案在『效能-品質』權衡上取得了極高水準的突破,將量化損失控制在 3% 內且提升了吞吐量,屬於極具實踐價值的工程優化。然而,其優勢建立在供應商端高昂的蒸餾訓練成本之上,這意味著該方案僅適用於擁有強大算力且追求極致終端體驗的模型開發商,而非一般中小規模的微調使用者。
此內容詳盡地展示了 Gemma 如何將 LLM 從『中心化雲端』轉向『分散式邊緣』,其策略成功在於將模型輕量化以適應極端場景,具備極高的實踐價值。然而,該生態系的繁榮仍高度依賴 Google 的基礎架構支持,且在醫療等高風險領域,AI 僅能作為『加速器』而非『決定者』,其最終效能仍受限於物理硬體的算力瓶頸。
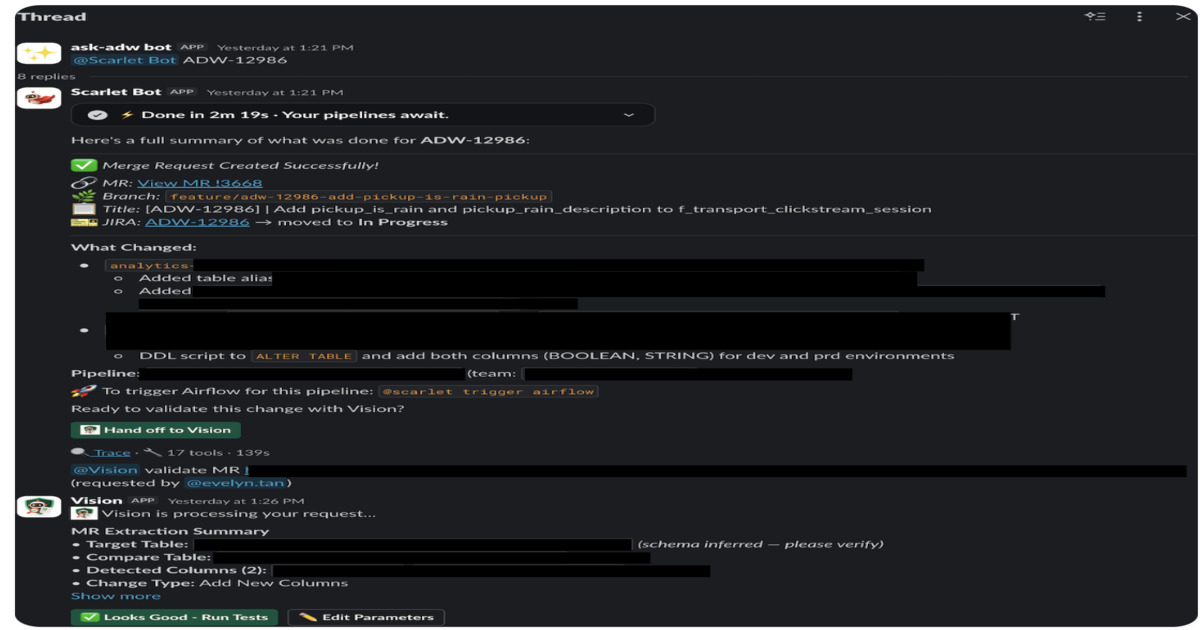
該方案是一套極具工程實踐價值的 AI 落地框架,其核心優勢在於建立了『分級自主模型』與『上下文管理系統 (ContextIQ)』,有效克服了 LLM 常見的幻覺問題並確保數據一致性。然而,其成功高度依賴於前期對 5,000 個認證指標與 4,000 份文檔的精細治理,這意味著缺乏強大數據基礎設施的中小企業難以直接複製,該模型在低數據成熟度環境下可能會失效。
該方案在理論上極具前瞻性,成功將『模糊的人類判斷』結構化為『可監控的 AI 流程』,有效解決了規模化審查的痛點。然而,其成敗高度依賴於校準集的品質與量表的精準度,若缺乏嚴格的信心水準過濾與人類升級機制,非確定性的 AI 輸出可能會引入新的維護噪音。
此方案精準捕捉了 AI 自動化開發中『信任與理解脫節』的痛點,提出以『數據實證』取代『文本審核』的邏輯,具有極高的實務前瞻性。然而,其成效高度依賴於企業既有的觀測數據質量與 OpenTelemetry 的部署程度,若基礎監控缺失,該工具鏈將淪為高級的自動化猜測工具。
該方案採取了一種極其保守且務實的工程路徑,將 LLM 的角色從『創造者』強行降級為『語義過濾器』。這種做法在商業生產環境中具有高度可行性,因為它用開發成本(增加僵硬度)換取了系統穩定性。然而,其效能上限將受限於開發者定義 Schema 的完備程度,若業務邏輯過於複雜,過度的解耦可能會導致維護成本激增。

此更新標誌著 LLM 從『單體暴力推理』向『分層協調架構』的範式轉移,評價為極高實用性的工程化進步。其核心價值在於將推理成本與準確率解耦,使大規模商業化部署具備經濟可行性;但其成敗保留在開發者的指令工程(Prompt Engineering)能力上,若無法精準定義觸發條件,自動化編排可能演變為成本黑洞。
該模型展現了極其激進的迭代速度與成本破壞策略,在編碼與工具調用等代理人核心能力上取得了量化突破,足以被評價為目前輕量化模型中的頂尖選擇。然而,其性能提升雖顯著,但仍處於百分比低位(如 AutomationBench 30.4%),顯示 AI Agent 距離完全自主化仍有較大差距,實際部署時仍需保留人工監督的必要性。
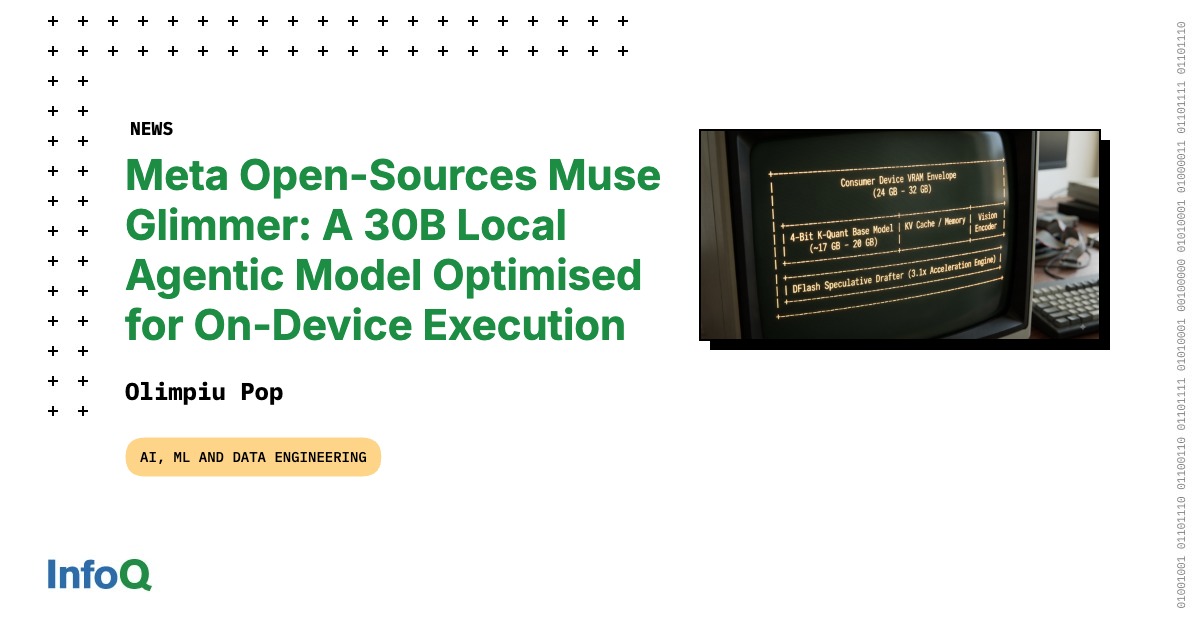
Muse Glimmer 是目前針對『本地化代理人』最務實的工業級嘗試。它並非追求參數規模的突破,而是精準地在 30B 規模與消費級 VRAM 限制之間取得了平衡,其對故障恢復能力的強化使其在實作面優於同級模型。然而,其高效能高度依賴特定高端硬體(如 M4 Max 或 RTX 50 系列),這意味著它尚未真正普及到『所有』消費級設備,而僅限於『高階』工作站用戶。
該更新將 Kubeflow 從單純的工具集推向標準化基礎設施,其將 Jupyter Notebook 直接轉換為生產管線的邏輯極具商業價值,能有效解決資料科學家與運維人員的脫節問題。然而,儘管功能強大,其系統複雜度依然極高,若缺乏完善的 UI/UX 優化或專業導師引導,中小企業在部署時仍會面臨陡峭的學習曲線。

該方案是一次成功的從『統計預測』向『認知代理』的範式轉移。其核心價值在於解決了 LLM 在處理海量離散 ID 時的無能,透過 RQ-VAE 將商品空間連續化,這在工程實踐上極具前瞻性。然而,該架構在推論延遲與碼本維護上的成本增加是不可避免的,其最終成敗取決於『推薦精準度提升帶來的營收』是否能覆蓋『計算資源增加的成本』。
此功能精準擊中了 LLM Agent 開發中『HTTP 200 但邏輯失敗』的痛點,提供了一套標準化的可視化方案,評價為『必要但尚未完美的診斷工具』。其價值在於將非結構化的推理過程轉化為結構化的 Span 追蹤,但由於預設隱私設定不一且存在數據截斷風險,開發者在將其視為正式審計工具前必須極其謹慎。