從唯讀到可寫:Cloudflare WriteGuard 如何為 MCP 伺服器建立 AI 代理人的安全防線
該方案精準地捕捉到了 AI Agent 從『資訊檢索』演進至『任務執行』過程中的核心痛點——權限失控。WriteGuard 透過將安全邏輯與業務邏輯解耦,提供了一套標準化的攔截機制,評價為『高效且具前瞻性的基礎設施補丁』。然而,其成效高度依賴於企業對『風險分級』定義的精準度,若分級過於寬鬆,該層防禦將形同虛設。
該方案精準地捕捉到了 AI Agent 從『資訊檢索』演進至『任務執行』過程中的核心痛點——權限失控。WriteGuard 透過將安全邏輯與業務邏輯解耦,提供了一套標準化的攔截機制,評價為『高效且具前瞻性的基礎設施補丁』。然而,其成效高度依賴於企業對『風險分級』定義的精準度,若分級過於寬鬆,該層防禦將形同虛設。
此方案精準捕捉了 AI 自動化開發中『信任與理解脫節』的痛點,提出以『數據實證』取代『文本審核』的邏輯,具有極高的實務前瞻性。然而,其成效高度依賴於企業既有的觀測數據質量與 OpenTelemetry 的部署程度,若基礎監控缺失,該工具鏈將淪為高級的自動化猜測工具。
該內容精準地捕捉到了 LLM 落地應用中的核心痛點——『資訊噪音』,其提出的從 Prompt 轉向 Context Engineering 的路徑具有高度的工程實踐價值。評價為『優質且具前瞻性』,因為它將 AI 交互從隨機的文字遊戲提升到了軟體資產管理的維度;但需保留條件是,該方案極大程度地增加了開發者的維護成本,若缺乏自動化工具支持,模組化管理可能會變成另一種形式的維護地獄。
此項變革是 AI Agent 生態系從『實驗性開發』邁向『工業級部署』的必然演進。將協議無狀態化雖犧牲了長連接的即時性,但極大化了雲端原生環境的擴展能力,評價為一次正確的修正;然而,其成功前提在於開發者能否承受重構舊有會話邏輯的遷移成本,且需依賴成熟的 API 網關來實現其治理價值。
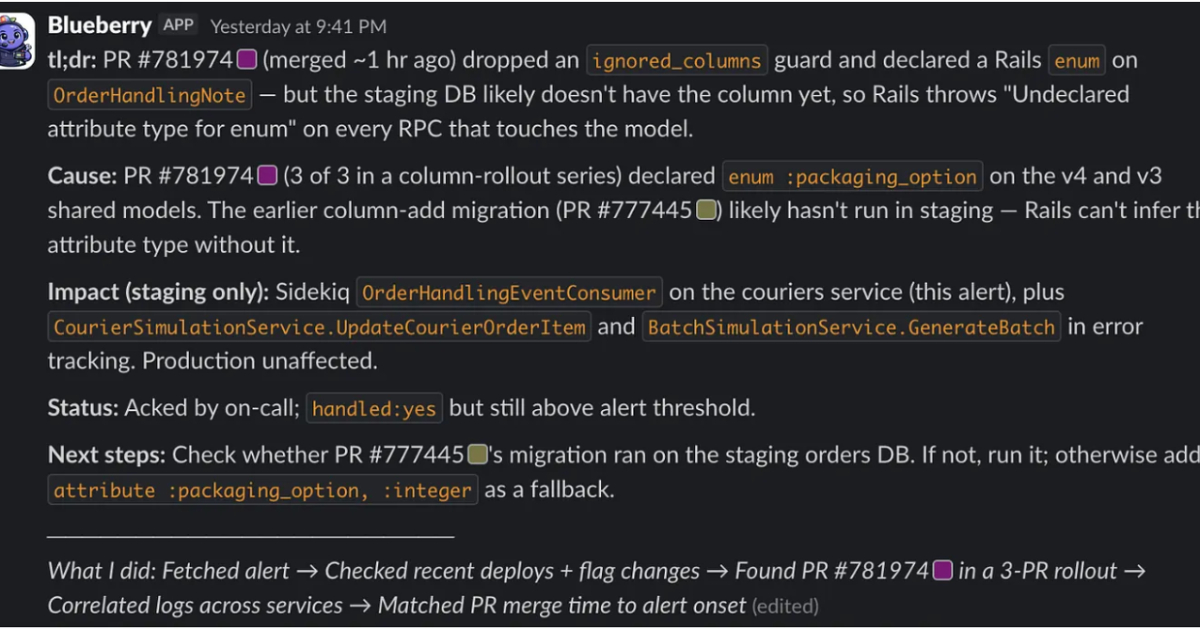
該系統展現了極高且務實的工程落地水準,其核心價值不在於 LLM 的推理,而是在於將『營運知識數位化』與『標準化工具介面 (MCP)』的深度整合。我評價其為『高效的資訊聚合體』而非『智能決策者』,這種克制的設計有效規避了 AI 在生產環境中直接操作的風險。然而,其成功高度依賴於 Instacart 累積 14 年的高質量歷史數據,對於缺乏標準化紀錄的組織而言,該方案的複製難度極高。
Microsoft 推出了 Azure API Management (APIM) 的 AI Gateway 專屬層級(預覽版),將控制平面從傳統的 API 轉向以模型 (Models) 與 MCP 伺服器為中心。此層級支持多供應商模型路由、簡化策略配置,並透過 MCP 協議將外部工具與 SaaS 應用整合為 AI 工具,旨在實現平台管理與團隊自服務的分離,同時提供統一的成本與流量治理。

該內容精準地揭示了 AI Agent 框架在追求『功能便利』與『安全邊界』之間的嚴重失衡。我判定此案例為典型的配置疏忽導致的系統性崩潰,其價值在於將傳統 RCE 與新型的『AI 記憶體中毒』概念掛鉤,提供了極具警示意義的技術分析;但需保留的是,文中對修復建議的描述較為基礎,未深入探討更深層的零信任架構(Zero Trust)實作。

此更新將 MCP 從『對話式插件』提升至『企業級微服務』等級,其將狀態管理移出協議層的決策極其正確,有效消除了雲端部署的瓶頸。然而,將互動邏輯交由 MRTR 處理雖維持了無狀態性,但增加了客戶端實現的複雜度,其效能表現仍需在極高併發場景下驗證。
該方案採取了極其理性且工程導向的設計,成功將LLM從「聊天機器人」轉化為「可控的運維組件」。其核心價值在於不盲信AI的推理能力,而是透過強制的 Policy as Code 建立物理隔離的審核機制,這是在高可用性環境(如5G網)部署AI的唯一正確路徑。然而,系統的成敗將高度依賴於 MCP 適配器的覆蓋率以及初始政策定義的精準度,若政策過於寬鬆,其安全防線將形同虛設。
此內容精準地指出了當前 Agent 開發中『提示詞工程過度』而『架構工程不足』的痛點,其提出的虛擬工具層與污點追蹤方案具有高度的工程實踐價值。然而,該方案的成功高度依賴於開發者對業務域的定義能力,若缺乏標準化的治理流程,虛擬工具層可能會演變成另一種形式的配置地獄。

此案例揭露了 AI 整合外部工具時最致命的『信任邊界模糊』問題。雖然微軟嘗試透過 Spotlighting 建立護欄,但實作上的不一致(漏掉特定 API)直接導致防禦崩潰,證明了在複雜系統中,單一環節的疏漏即可使整體安全機制失效。評價為:高風險且具代表性的邏輯漏洞,提醒開發者不可依賴 UI 隱藏來達成安全性。

該內容精確地揭示了 AI Agent 在獲取系統權限後,因缺乏硬性權限邊界而導致的典型安全崩潰。我評價此案例為『AI 權限管理的教科書級失敗』,其核心問題在於過度信任 AI 的判斷與形式化的審核流程;但其修復方案(將控制權移交平台層)提供了正確的防禦方向,前提是開發者必須放棄對 AI 邏輯的依賴,轉向基於能力的強制權限控制。