
從 FakeGit 攻擊分析:當 AI Agent 成為惡意軟體的傳播媒介
此案例揭示了 AI 代理人(AI Agent)在自動化探索階段的致命信任漏洞。我判定這是一種高效率且具前瞻性的攻擊演進,因為它將『信任轉移』從人類轉向了 AI,利用 AI 的推薦權威來繞過使用者的警覺心。然而,此攻擊仍依賴於使用者對 AI 建議的盲從,若企業能實施嚴格的沙箱隔離與白名單機制,該攻擊路徑將被有效阻斷。
此案例揭示了 AI 代理人(AI Agent)在自動化探索階段的致命信任漏洞。我判定這是一種高效率且具前瞻性的攻擊演進,因為它將『信任轉移』從人類轉向了 AI,利用 AI 的推薦權威來繞過使用者的警覺心。然而,此攻擊仍依賴於使用者對 AI 建議的盲從,若企業能實施嚴格的沙箱隔離與白名單機制,該攻擊路徑將被有效阻斷。
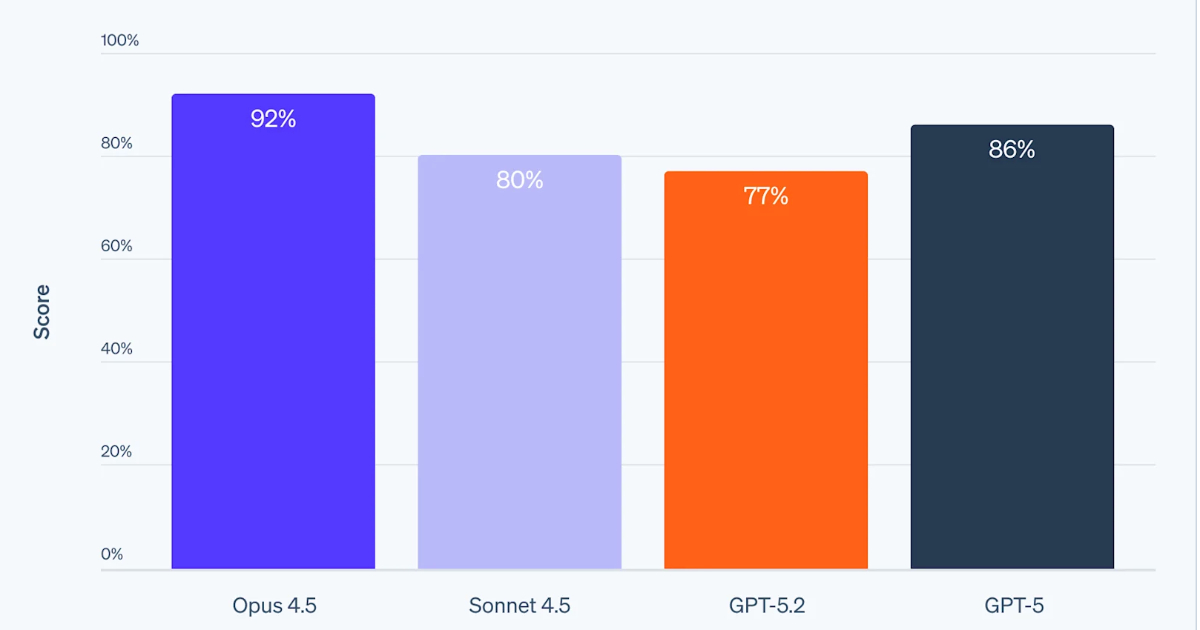
此內容精準捕捉了 AI 開發從『工具』向『代理』轉型的核心痛點。我判定該分析具有高參考價值,因為它將焦點從單純的生成率移至『驗證閉環』,揭示了 AI 在處理負面訊號時的邏輯缺失;然而,其結論仍基於目前模型版本,需保留對下一代模型在自我修正能力(Self-correction)突破後的評估空間。
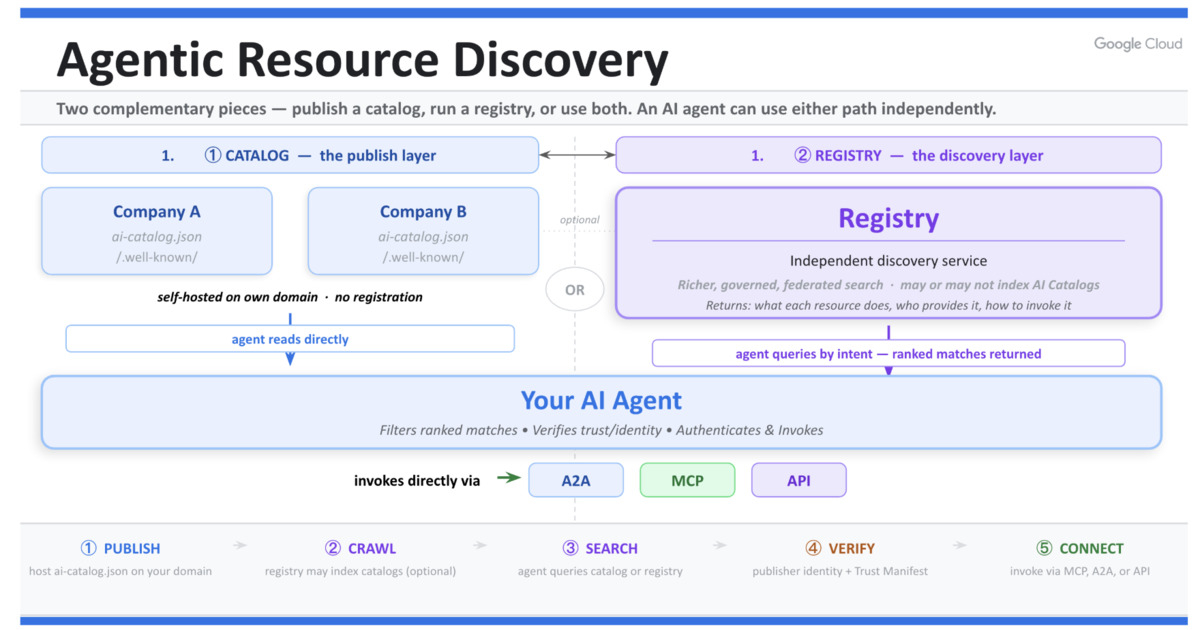
此規範是從『靜態配置』轉向『動態生態』的必要演進,邏輯嚴密且填補了 MCP 在發現階段的空白。然而,其成敗高度依賴於企業對 ai-catalog.json 的維護意願與標準化程度,若缺乏強大的生態驅動力,恐淪為另一套缺乏實作的空殼協議。

該內容精準地捕捉到了現代資安運維中『訊號過載』與『決策脫節』的痛點,提出將 AI 從『推測者』升級為『證據分析師』的邏輯路徑,具有極高的實務指導價值。然而,其成效高度依賴於底層驗證引擎(如 Pentera)的覆蓋率與準確性,若驗證工具本身存在盲點,AI 仍會陷入『基於錯誤證據的精準決策』之陷阱。
此更新將 Copilot CLI 從『指令翻譯機』演進為『終端操作系統』,其核心價值在於將 MCP 協定標準化,打破了 AI 與外部數據的壁壘。評價為『高度實用且具前瞻性』,因為它精準擊中了工程師頻繁切換視窗的痛點;但保留條件在於 MCP 生態系的第三方伺服器數量,若 Registry 缺乏足夠的插件支持,其擴展潛力將受限。

此內容精準地捕捉到了從『靜態組件管理』到『動態生成治理』的範式轉移,具有高度的前瞻性。其核心價值在於將 AI 模型與代理人定義為新型依賴項,而非單純的工具,這在邏輯上是成立且必要的。然而,文中對於『可利用性導向』的實作路徑描述較為簡略,在缺乏具體自動化工具鏈支持的情況下,將其落地至大規模工程團隊仍存在執行難度。
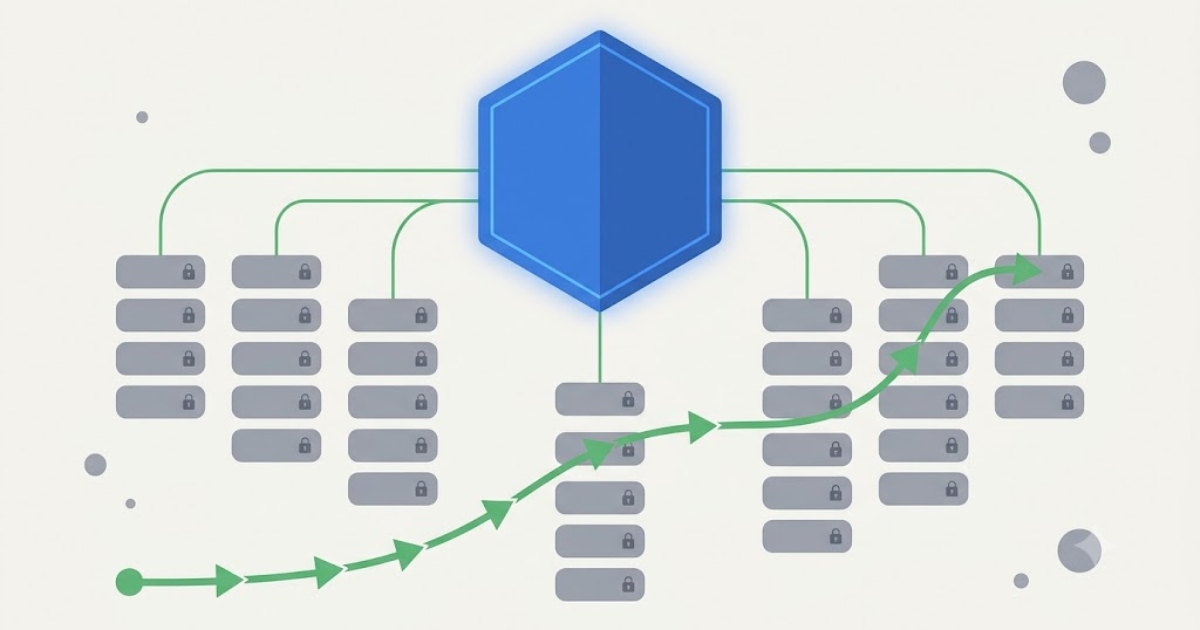
此方案在解決『規模化部署』的痛點上極具前瞻性,將 AI 存取標準化從個人層級提升至企業治理層級,評價為『必要且高效的基礎建設』。然而,其核心風險在於將『連線權限』與『操作權限』分離,若開發者誤以為 EMA 提供了全方位的安全保障而忽略後端執行層級的細粒度控管,將導致嚴重的資安漏洞。

該內容精準地捕捉到了 Agentic AI 轉型期的核心安全痛點,將『描述文字即指令』的邏輯漏洞分析得非常透徹,具有高度的警示價值。然而,其評價僅限於『風險揭露』層面,雖然提供了工程建議,但缺乏針對不同規模企業的實施優先級分級,建議在實務部署時需考量效能與安全性的權衡。

此方案將 AI 從『對話框』推向『基礎設施』,透過 MCP 協議解決了 AI 分析海量日誌時常見的 Token 浪費與幻覺問題,是一種極具實踐價值的工程化升級。然而,其成效高度依賴於 Binlog 伺服器的工具集完整度以及 CI 環境的容器化配置成本,對於小型專案而言,導入門檻可能高於其帶來的邊際收益。

此漏洞揭示了 AI 助手在追求『自動化集成』時對安全邊界的嚴重忽視。雖然功能擴展(MCP)提升了生產力,但將不可信的設定檔直接映射為可執行行程是典型的設計缺陷。評價為『高風險且具系統性』,因為這並非單一產品問題,而是目前 AI IDE 類產品普遍存在的信任模型崩潰,除非能徹底實施沙箱化執行,否則僅靠『手動確認』僅能降低而非消除風險。
此更新將複雜的 Agent 邏輯簡化為配置化文件,是一種極具野心的『開發範式轉移』。我認為其將 Markdown 作為定義層能極大降低進入門檻,但其成敗取決於 .agent.md 在處理複雜狀態機時是否會陷入配置地獄,且過度依賴 LLM 推論速度可能使 Serverless 的低延遲優勢被抵消。

此案例揭露了開發者在構建 AI Agent 時對『本地信任邊界』的認知嚴重滯後。雖然漏洞鏈的組成要素(缺乏驗證、未過濾輸入)屬於初級安全失誤,但在 Agent 賦予模型『外部感知能力』的背景下,這些傳統漏洞被放大為高風險的 RCE 途徑。整體評價為『典型的開發便捷性凌駕於安全性之上的失敗案例』,但其警示價值極高,前提是開發者必須意識到 Agent 本身就是一個潛在的攻擊向量。