
AI 程式能力評測的陷阱:從 SWE-bench Pro 案例分析與信號雜訊之辨
該內容精準地揭示了當前 AI 評測體系中『自動化生成』與『真實能力衡量』之間的嚴重脫節。我判定此分析具有高度價值,因為它挑戰了業界對基準得分的盲目崇拜,明確指出 30% 的損壞率足以使任何量化對比失效。然而,其結論高度依賴於 OpenAI 自身的審核管線,在缺乏第三方獨立驗證前,應將此視為一種『方法論警示』而非絕對真理。
該內容精準地揭示了當前 AI 評測體系中『自動化生成』與『真實能力衡量』之間的嚴重脫節。我判定此分析具有高度價值,因為它挑戰了業界對基準得分的盲目崇拜,明確指出 30% 的損壞率足以使任何量化對比失效。然而,其結論高度依賴於 OpenAI 自身的審核管線,在缺乏第三方獨立驗證前,應將此視為一種『方法論警示』而非絕對真理。
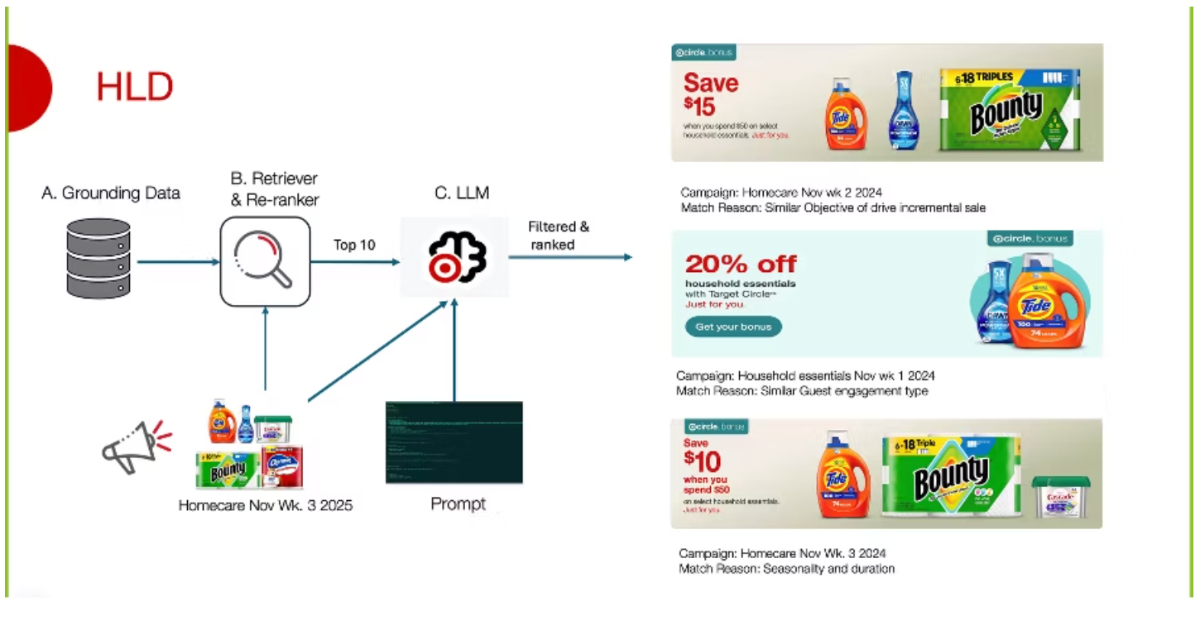
該方案展現了極高且務實的工程落地水準,將 LLM 的強項(推理與解釋)與向量檢索的強項(高效篩選)精準結合,有效解決了傳統硬編碼規則的擴展性危機。然而,其成功高度依賴於高品質的結構化元數據標準化,若初始數據標籤混亂象嚴重,Embedding 的距離計算將失去業務意義,因此其通用性受限於企業的數據治理能力。

該內容精準地將數據報告轉化為產品成長模型,其價值在於將『深度』與『廣度』量化為用戶留存指標,具有高度的分析參考價值。然而,其結論過於依賴 OpenAI 提供的單方數據,缺乏第三方對比驗證,在評估 AI 是否真正縮小數位鴻溝時仍需保留對『資訊依賴』風險的觀察。

此內容精準地將複雜的電信工程概念(全雙工)轉化為 AI 架構的解釋,邏輯推演清晰且具備技術深度,是一篇高品質的技術轉譯文章。然而,其評價前提是讀者已具備基礎 LLM 認知,且文中對『委派機制』的描述較為簡略,缺乏具體的 API 調用或異步處理細節,對於追求底層實現的資深工程師而言,資訊密度略顯不足。

該內容精準地解構了混合架構在語義理解與結構複製之間的權衡,是一篇高品質的技術分析。我判定此路徑為 LLM 演進的正確方向,因為它解決了純 Transformer 在長序列計算成本與動態狀態維護的矛盾;但其成效仍取決於遞迴層記憶體損耗(Lossy)的容忍度,若應用場景對絕對精確度要求極高,該架構仍有風險。

該方案展現了極高水準的工程實踐,其核心價值在於不盲信 AI,而是將 LLM 定位為『高效草擬者』而非『最終決策者』。透過『非確定性模型 + 確定性護欄』的架構,成功在效率與可靠性之間取得平衡,是一個可高度複製的工業級 AI 整合範本,前提是團隊必須具備定義 Ground Truth 的能力。
此方案在工程實踐上具有高度價值,它精準地切中了 AI 研究員與基礎設施工程師之間的協作斷層。透過解耦設計將複雜的 K8s 管理抽象化,能顯著提升開發速度,但其成效高度依賴於團隊對 Kubernetes 的基礎維運能力,若缺乏集群管理經驗,其『自託管』的特性反而可能成為新的維護負擔。
此內容精準捕捉了教育 AI 從『通用能力』轉向『受控實作』的範式轉移,其提出的 RAG 與 MCP 整合路徑具有高度的工程可行性。然而,該方案過度依賴 Google 的生態系(如 Chromebook 與 Classroom),在跨平台兼容性上存在明顯的閉環風險,僅在全家桶環境下能達到最大效能。
此內容精準地將 LLM 從『智能個體』還原為『統計工具』,具有極高的工程實務價值。其評價為『優良』,因為它不僅指出了模型缺陷,更將其轉化為可操作的開發準則;但保留條件在於,文中對『群體投票效應』的描述過於簡化,未深入討論不同模型架構在機率分佈處理上的差異。
此更新將複雜的 Agent 邏輯簡化為配置化文件,是一種極具野心的『開發範式轉移』。我認為其將 Markdown 作為定義層能極大降低進入門檻,但其成敗取決於 .agent.md 在處理複雜狀態機時是否會陷入配置地獄,且過度依賴 LLM 推論速度可能使 Serverless 的低延遲優勢被抵消。

此方案是一次極其理性且正確的工程回歸,它承認了 LLM 在處理非結構化業務邏輯時的本質不穩定性。評價為『高效但高門檻』:其成功在於將 AI 定位為『執行者』而非『定義者』,但前提是企業必須具備極強的數據治理紀律,否則該架構將淪為昂貴的維護負擔。
此內容精準捕捉了 Apple 從傳統 ML 向生成式 AI 轉型的底層邏輯,技術路徑清晰且具備實作參考價值。我評定其為『高質量技術導引』,因其不僅解釋了 What,更詳細說明了 How(如 Zero-copy 與 AOT),但其最終成效仍保留在於第三方開發社群對該封閉生態的採納率。