
從對話到執行:NTT DATA 如何利用 Codex 將三天的事故分析縮短至 30 分鐘
此案例展現了 AI 從『知識檢索』跨越至『任務執行』的實質轉型,其價值在於將 AI 定位為能閉環執行任務的 Agent 而非僅是聊天機器人。我評價此路徑為高度可行且具備規模化潛力,因為它解決了企業導入 AI 最核心的『最後一哩路』執行問題;但其成功前提是必須擁有如 CoE 般嚴謹的治理框架,否則 Agent 的自主執行權限將成為巨大的資安風險。
此案例展現了 AI 從『知識檢索』跨越至『任務執行』的實質轉型,其價值在於將 AI 定位為能閉環執行任務的 Agent 而非僅是聊天機器人。我評價此路徑為高度可行且具備規模化潛力,因為它解決了企業導入 AI 最核心的『最後一哩路』執行問題;但其成功前提是必須擁有如 CoE 般嚴謹的治理框架,否則 Agent 的自主執行權限將成為巨大的資安風險。
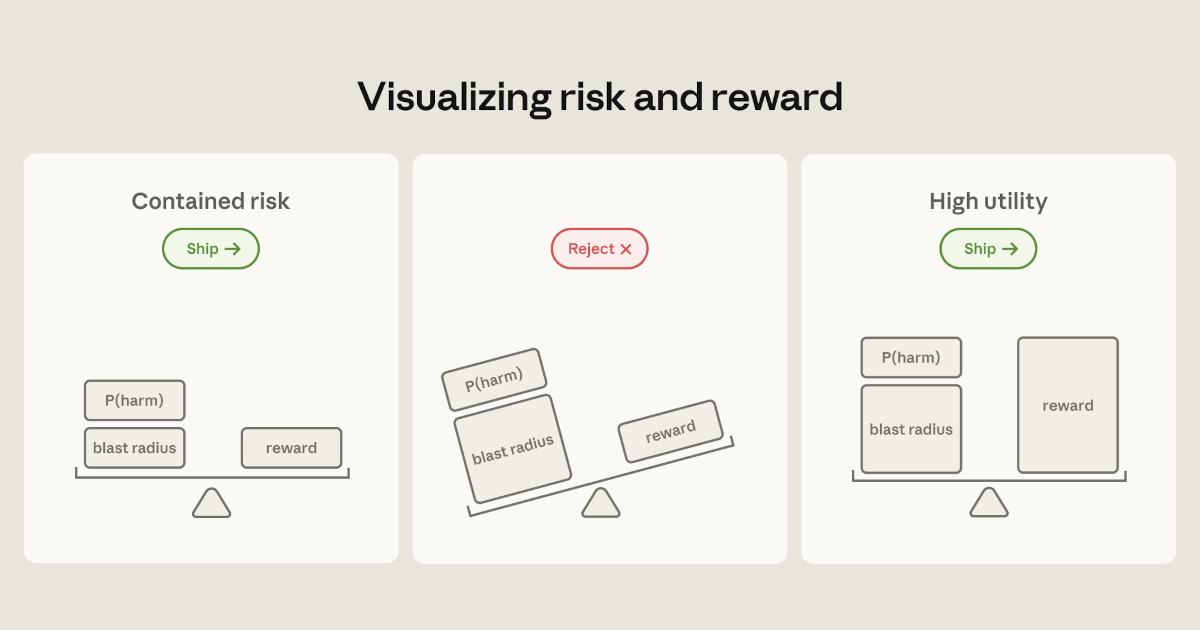
該內容精準地指出了當前 AI 開發者對『提示詞安全』的過度依賴,其核心價值在於將安全維度從『行為管理』提升至『基礎設施限制』。我評價此方案為高度實務且必要,因為它承認了 LLM 的機率性本質,而非幻想完美的對齊。然而,其保留條件在於:極端的隔離可能會犧牲 Agent 的靈活性與開發效率,工程師需在『絕對安全』與『功能可用性』之間尋找平衡點。
此內容精準地指出了當前 Agent 開發中『提示詞工程過度』而『架構工程不足』的痛點,其提出的虛擬工具層與污點追蹤方案具有高度的工程實踐價值。然而,該方案的成功高度依賴於開發者對業務域的定義能力,若缺乏標準化的治理流程,虛擬工具層可能會演變成另一種形式的配置地獄。

此案例揭露了 AI 整合外部工具時最致命的『信任邊界模糊』問題。雖然微軟嘗試透過 Spotlighting 建立護欄,但實作上的不一致(漏掉特定 API)直接導致防禦崩潰,證明了在複雜系統中,單一環節的疏漏即可使整體安全機制失效。評價為:高風險且具代表性的邏輯漏洞,提醒開發者不可依賴 UI 隱藏來達成安全性。

該內容精準地將模型更新轉化為工程實務建議,而非單純的規格堆砌,具有高參考價值。其核心價值在於提出了 Master-Worker 的分層架構,有效解決了 LLM 在生產環境中『能力與成本』的矛盾;但需保留之處在於,文中未提及具體的 Token 價格對比數據,導致『經濟選擇』的量化依據不足。

此方案在工程權衡上極其精明,捨棄通用大模型的冗餘而追求 Flash 版本的低延遲與高迭代,使其在實戰漏洞挖掘中具備壓倒性效率。然而,其能繞過 ASLR 與 W^X 的能力使其成為危險的雙刃劍,Google 採取封閉式部署是必要的風險控制,但這也意味著該技術短期內無法普惠於一般開發者,其真實防禦效能仍需在非受控環境中驗證。
此更新標誌著 IDE 從『被動建議』轉向『主動代理』的關鍵轉折,其平行對話設計有效打破了線性交互的低效,評價為『高實用性的工程演進』。然而,AI 自動修復功能的實際可靠性仍取決於 Android Bench 的評估基準是否能涵蓋所有邊緣案例,開發者在授權 AI 修改程式碼時仍需保持審慎的審核機制。
此內容準確捕捉了 AI 從『對話』轉向『執行』的範式轉移,評價為高度前瞻且具實務價值。其核心優勢在於將 AI 代理人與硬體生態(摺疊螢幕、眼鏡)深度綁定,而非單純的模型升級;但需保留對『螢幕感知(Screen Awareness)』在極端複雜 UI 下的穩定性以及隱私權限管理的質疑。

該內容精準地揭示了當前 AI Agent 框架在『信任邊界』定義上的嚴重缺失。我判定這類工具目前在生產環境中具有高風險,因為開發者錯誤地將 LLM 視為可信輸入源,導致其成為典型的命令注入媒介;但此判斷僅限於目前缺乏 Sanitization 的開源框架,若導入參數化指令與串流傳輸,風險可被有效壓制。
此方案精準擊中了 AI 時代下『產出過剩、審核不足』的痛點,將 AI 定位從『生成者』轉向『修正者』是極具前瞻性的戰略轉移。然而,其成效高度依賴於 CI/CD 流水線的完備程度,若測試覆蓋率不足,AI 的自動修復可能會在通過 Pipeline 的同時引入隱蔽的邏輯錯誤,因此人類的最終審核權限仍是不可或缺的防線。
該內容精準地捕捉了 AI 安全範式轉移的關鍵點,將討論從表層的『對話過濾』提升至深層的『系統權限控制』,具有高度的實務參考價值。然而,其分析仍基於特定測試案例,對於在極端複雜的企業級混合雲環境中,如何平衡 AI 的自主執行力與絕對隔離的衝突,尚未提供具體的技術路徑,僅止於原則性建議。

此案例揭示了 AI Agent 在攻擊面上的極高效率,其自動化擴張速度已超越傳統人工監控。我認為該給予正面評價的是其對『防禦悖論』的精準捕捉——過度依賴封閉模型的安全限制將導致防禦者在危機中失能。但需保留的是,本文側重於單一事件分析,尚未討論如何建立一套能自動對抗 AI Agent 的動態防禦體系。