別讓 AI 產品死於『評估債』:從工程實務看 AI 評估體系的五層架構
該內容精準地捕捉到了當前 LLM 落地最核心的痛點——『量化指標與實際價值脫節』。我評價此觀點為『極具實戰價值的警示』,因為它將 AI 評估從單純的數學問題提升到了系統工程與心理學高度。然而,其提出的五層架構在實作上具有高度複雜性,若缺乏強大的數據標記能力,容易淪為理論上的完美,而難以在快速迭代的開發週期中全面落地。
該內容精準地捕捉到了當前 LLM 落地最核心的痛點——『量化指標與實際價值脫節』。我評價此觀點為『極具實戰價值的警示』,因為它將 AI 評估從單純的數學問題提升到了系統工程與心理學高度。然而,其提出的五層架構在實作上具有高度複雜性,若缺乏強大的數據標記能力,容易淪為理論上的完美,而難以在快速迭代的開發週期中全面落地。
該方案展現了極高水準的工程實踐,將『成本管理』從隨機的調優轉化為可量化的系統工程,評價為『卓越且具備高度可複製性』。其核心優勢在於定義了 Effective Tokens 這一統一指標,解決了多模型價格混亂的痛點;然而,其效果高度依賴於上下文比例,對於本身輸入量巨大的任務,剪枝效果將顯著遞減,這點是導入此方案時必須保留的預期限制。
該工具成功將 AI 從『建議者』轉型為『執行者』,透過解耦模型層(BYOK)與深度整合 CI 管線,提供了極高的工程靈活性。然而,其效能高度依賴於開發者對 Prompt 的調優以及所選模型的推理能力,若缺乏嚴謹的權限管控,自動提交代碼可能引入不可預見的風險。

此內容精確捕捉了開發範式的轉移,我判定 Vibe Coding 是極高效的原型驗證工具,能大幅降低進入門檻;然而,其評價需保留在『複雜系統不可替代』的前提下,因為過度依賴 Vibe 而忽略架構嚴謹性將導致技術債崩潰。

本內容精準捕捉了 LLM 從『生成』轉向『執行』的範式轉移,技術邏輯清晰且具前瞻性。我判定其價值在於將複雜的模型差異具象化為『創造力』與『執行力』的對比,但在缺乏實際 API 實作細節點的條件下,其對工程師的指導意義仍偏向概念驗證而非落地指南。
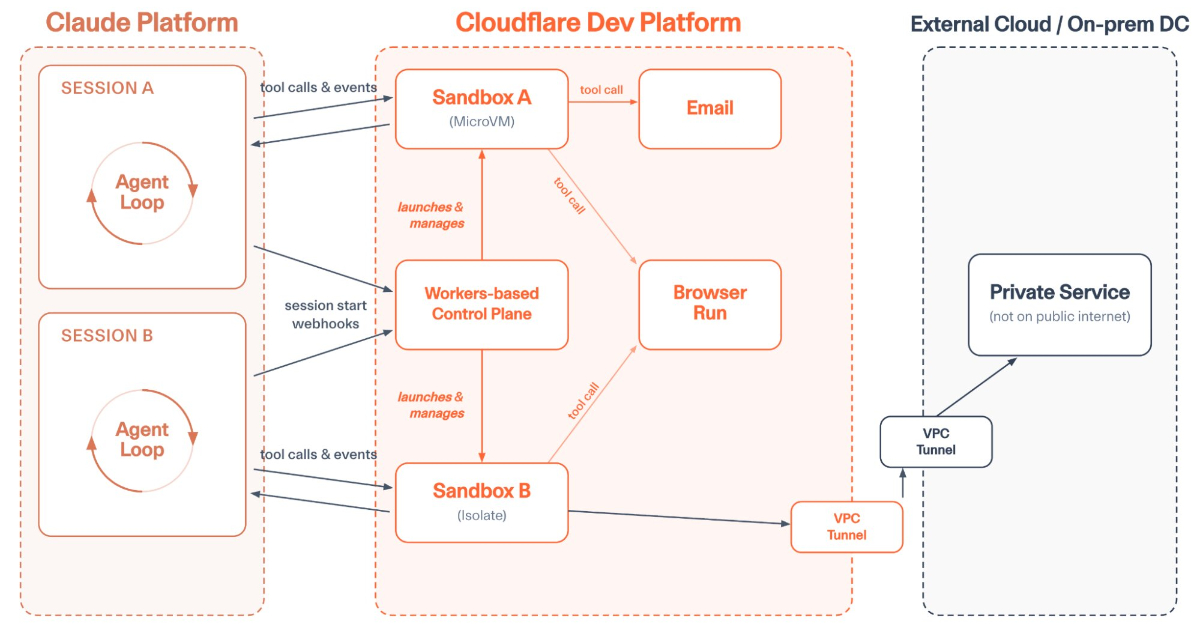
此方案在技術路徑上採取了極其務實的「權限解耦」策略,有效地將 AI 的推理能力與執行權限切分,是目前解決企業級 AI 落地信任危機的最佳實踐之一。然而,其評價需保留在『運維複雜度』與『成本不可控性』上,因為多平台依賴將增加除錯難度,且 Token 與運算資源的雙重計費可能在大規模部署時產生不可預見的開銷。

該內容客觀地揭露了通用 AI 模型在垂直專業領域(SRE)的實踐落差,其價值在於將『對話能力』與『執行能力』區分開來。我判定此評測具有高度參考意義,因為它採用了嚴苛的 Recall-gated Precision 評分,而非寬鬆的對話評分,但其結論仍受限於目前的沙盒模擬環境,實際部署於動態生產環境的變數可能更高。
此內容精準捕捉了 AI 從『交互式』向『代理式』轉型的範式轉移,評價為高度前瞻且具實作邏輯。其核心價值在於將 Generative UI 與 Cloud-based Agent 結合,打破了傳統 LLM 的對話框架,但其實際成敗保留在隱私權限的開放程度以及跨應用操作的穩定性上。
此更新將 AI Agent 從「建議者」提升為「執行者」,在功能擴展上具有高度實用價值。其選擇 Hyper-V 硬體級隔離而非輕量級隔離(如 V8 Isolates),顯示微軟在企業級安全上的保守且穩健的取向。然而,該功能的效能將高度依賴 Azure Container Apps 的冷啟動速度與 Session Pool 管理,在極低延遲需求的場景中可能仍有瓶頸。
該內容精準地擊中了當前 AI 工程化最核心的痛點:隨機性導致的不可靠。我判定此觀點具有高度實務價值,因為它將 LLM 定位為『協調者』而非『執行者』,有效對沖了幻覺風險;但其前提是開發者必須具備強大的傳統軟體工程能力來構建『工具層』,若缺乏底層確定性開發能力,此框架將淪為空中樓閣。
此內容提供了一套極具實踐價值的 AI 代理人演進框架,將 LLM 從『生成器』成功定義為『執行系統』。其核心價值在於明確區分了模型能力與框架能力的邊界,但在醫療等高風險領域的落地,仍高度依賴於底層數據的質量與 Re-ranker 的精準度,若數據源本身存在嚴重偏差,即便有強健的 Harness 也無法完全消除事實性錯誤。
此方案在解決金融業『最後一哩路』的低效能痛點上具有極高實務價值,其核心優勢在於追求『原生可編輯文件』而非靜態圖片,這符合金融審核的嚴格邏輯。然而,儘管數據表現優異,但其對傳統 Office 邏輯的依賴仍是短期瓶頸,真正的突破需取決於其能否成功轉型為動態可追溯的知識庫。