
Google Sheets Canvas:將試算表數據轉化為互動式視覺化微應用
此功能是 Google 試圖將『數據儲存』與『數據操作』分離的成功嘗試,將試算表從工具升級為平台。其核心價值在於極大化降低了非技術人員的開發門檻,但其高度依賴訂閱制權限,意味著這將成為一種階級化的生產力特權,而非普惠的基礎功能。
此功能是 Google 試圖將『數據儲存』與『數據操作』分離的成功嘗試,將試算表從工具升級為平台。其核心價值在於極大化降低了非技術人員的開發門檻,但其高度依賴訂閱制權限,意味著這將成為一種階級化的生產力特權,而非普惠的基礎功能。

該產品在工業設計上展現了極高的迭代效率,特別是無齒輪轉軸對耐用度的量化提升具有實質意義。然而,其核心競爭力在於將 AI 從單純的軟體功能轉化為『硬體交互』(如 HiLight 與 Sign-to-Text),使其脫離單純的規格競賽。保留條件在於 Tensor G6 的實際能效比是否能支撐高亮度螢幕與 AI 運算的續航壓力。

此功能是將『環境光訊號』作為認知緩衝層的聰明嘗試,有效解決了 AI 處理延遲的焦慮感,評價為優良的互動設計。然而,其成敗高度依賴使用者的色彩記憶能力與環境光線對比度,若缺乏直覺的顏色標準,可能會演變成另一種需要學習的認知成本。
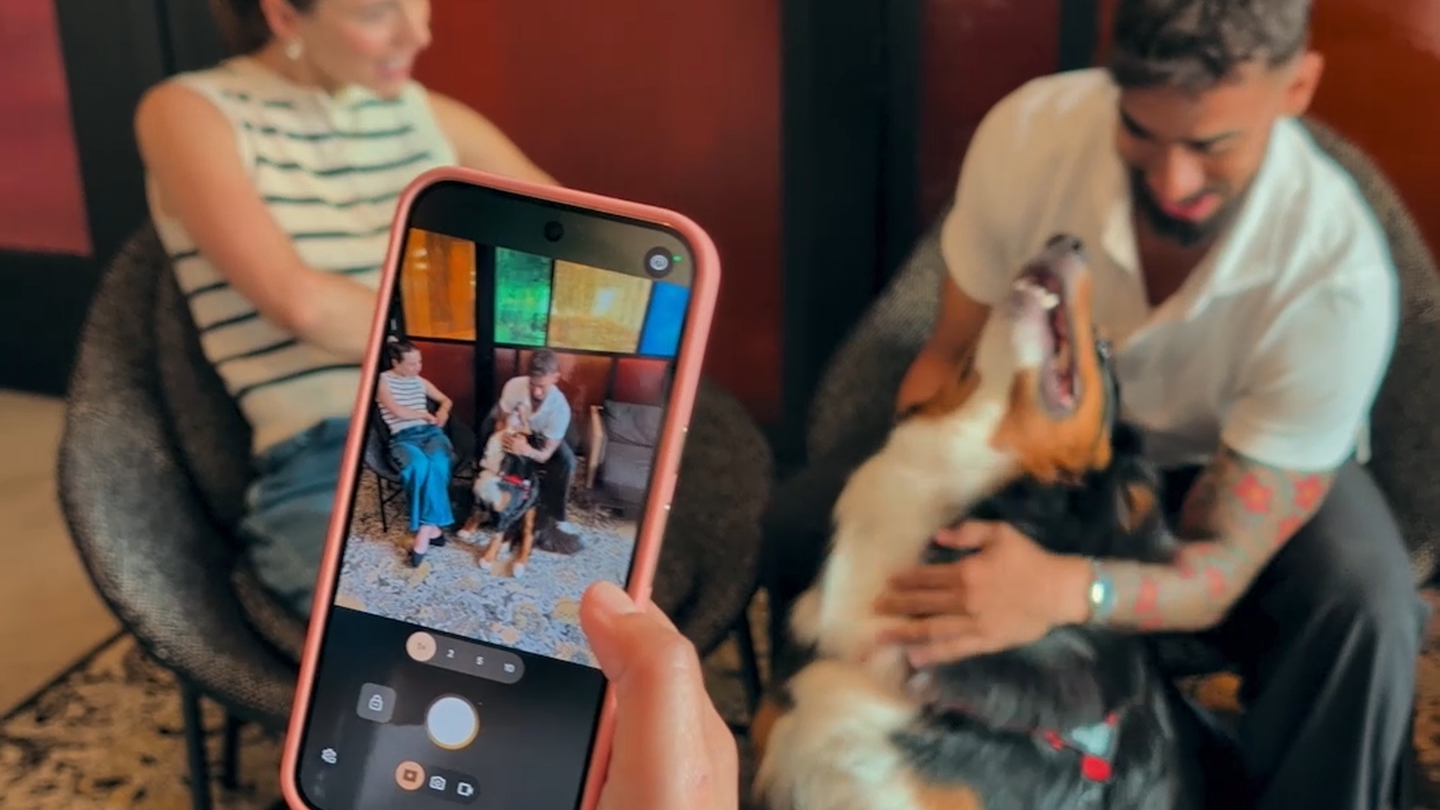
此功能在技術邏輯上將攝影從『點狀捕捉』進化為『區間管理』,是一次高效的體驗優化,能顯著降低使用者操作成本。然而,其價值高度依賴於 AI 對『情感瞬間』定義的精準度,若演算法過於機械化,可能會導致產出照片缺乏靈魂,且高強度的即時運算將對硬體功耗造成壓力。
該模型展現了極其激進的迭代速度與成本破壞策略,在編碼與工具調用等代理人核心能力上取得了量化突破,足以被評價為目前輕量化模型中的頂尖選擇。然而,其性能提升雖顯著,但仍處於百分比低位(如 AutomationBench 30.4%),顯示 AI Agent 距離完全自主化仍有較大差距,實際部署時仍需保留人工監督的必要性。
Muse Glimmer 是目前針對『本地化代理人』最務實的工業級嘗試。它並非追求參數規模的突破,而是精準地在 30B 規模與消費級 VRAM 限制之間取得了平衡,其對故障恢復能力的強化使其在實作面優於同級模型。然而,其高效能高度依賴特定高端硬體(如 M4 Max 或 RTX 50 系列),這意味著它尚未真正普及到『所有』消費級設備,而僅限於『高階』工作站用戶。
此更新是一次典型的『去冗餘』維護,將 UI 框架強耦合的技術債轉化為模組化依賴,在工程實踐上極具價值。我評價此次更新為『高效率的基礎設施修補』,因為它直接擊中了現代 .NET 部署(尤其是 AOT)的痛點,但其對舊版 packages.config 的不兼容限制了部分遺留系統的無痛遷移。
該更新將 Kubeflow 從單純的工具集推向標準化基礎設施,其將 Jupyter Notebook 直接轉換為生產管線的邏輯極具商業價值,能有效解決資料科學家與運維人員的脫節問題。然而,儘管功能強大,其系統複雜度依然極高,若缺乏完善的 UI/UX 優化或專業導師引導,中小企業在部署時仍會面臨陡峭的學習曲線。
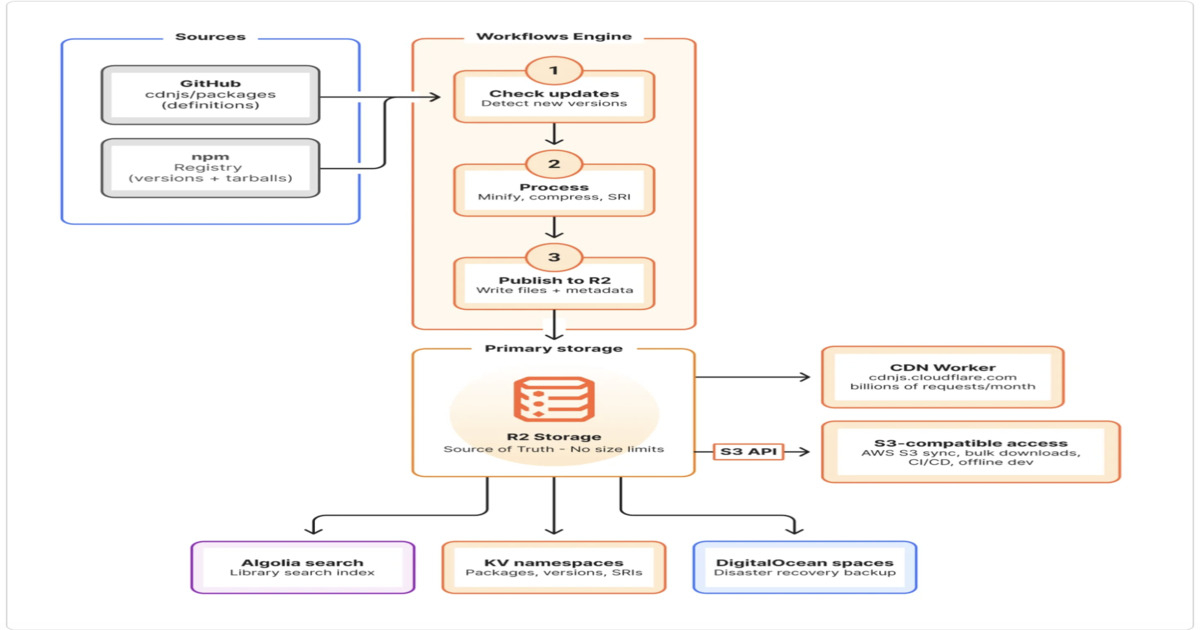
此案例是典型的企業級『自我驗證』策略,透過將關鍵基礎設施 cdnjs 遷入自有平台,強行壓榨產品極限以驅動功能演進。雖然在壓縮演算法上仍需依賴容器而非純 Workers 實現,顯示邊緣運算在記憶體密集型任務上仍有瓶頸,但整體架構從混合雲轉向單一棧的決策極其果斷且高效,具有高度的技術參考價值。
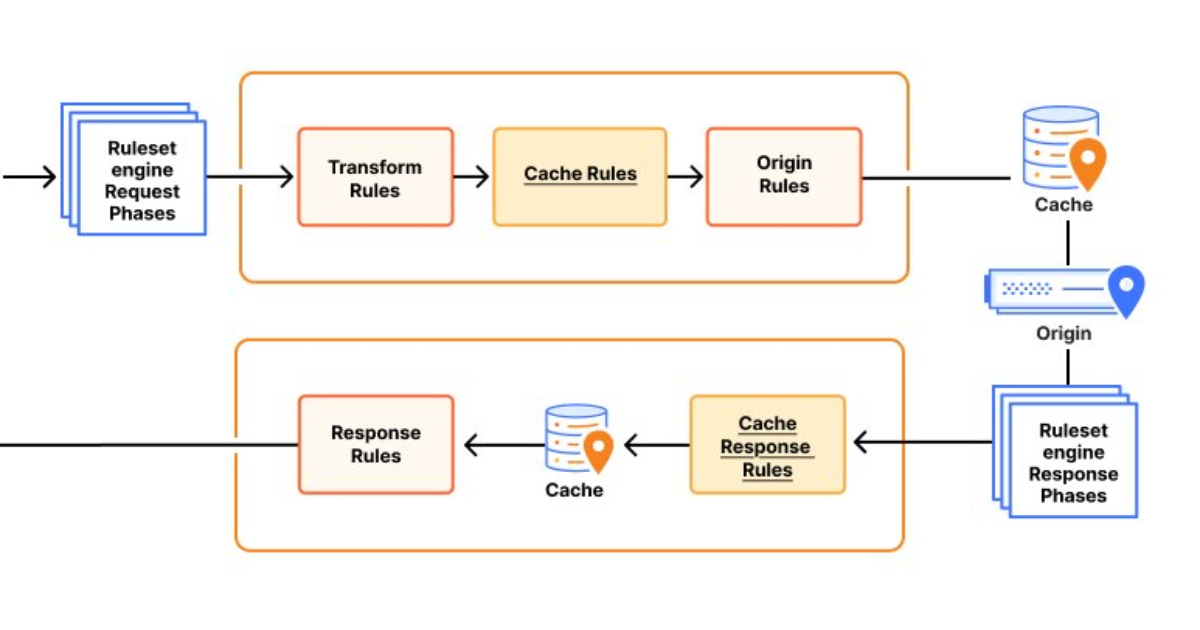
此內容精確地捕捉了 CDN 運作中『請求階段』與『回應階段』的技術斷層,並將 Cache Response Rules 定位為有效的修補手段。我評定此方案在維運靈活性上具有高度價值,能快速解決遺留系統(Legacy System)無法修改代碼的痛點;然而,該工具賦予了邊緣端過高的權限,若缺乏嚴格的規則審核機制,將極易觸發快取污染等安全漏洞,因此其評價為『強大權在握但風險隨行』的雙面刃工具。

該方案是一次成功的從『統計預測』向『認知代理』的範式轉移。其核心價值在於解決了 LLM 在處理海量離散 ID 時的無能,透過 RQ-VAE 將商品空間連續化,這在工程實踐上極具前瞻性。然而,該架構在推論延遲與碼本維護上的成本增加是不可避免的,其最終成敗取決於『推薦精準度提升帶來的營收』是否能覆蓋『計算資源增加的成本』。
此功能精準擊中了 LLM Agent 開發中『HTTP 200 但邏輯失敗』的痛點,提供了一套標準化的可視化方案,評價為『必要但尚未完美的診斷工具』。其價值在於將非結構化的推理過程轉化為結構化的 Span 追蹤,但由於預設隱私設定不一且存在數據截斷風險,開發者在將其視為正式審計工具前必須極其謹慎。