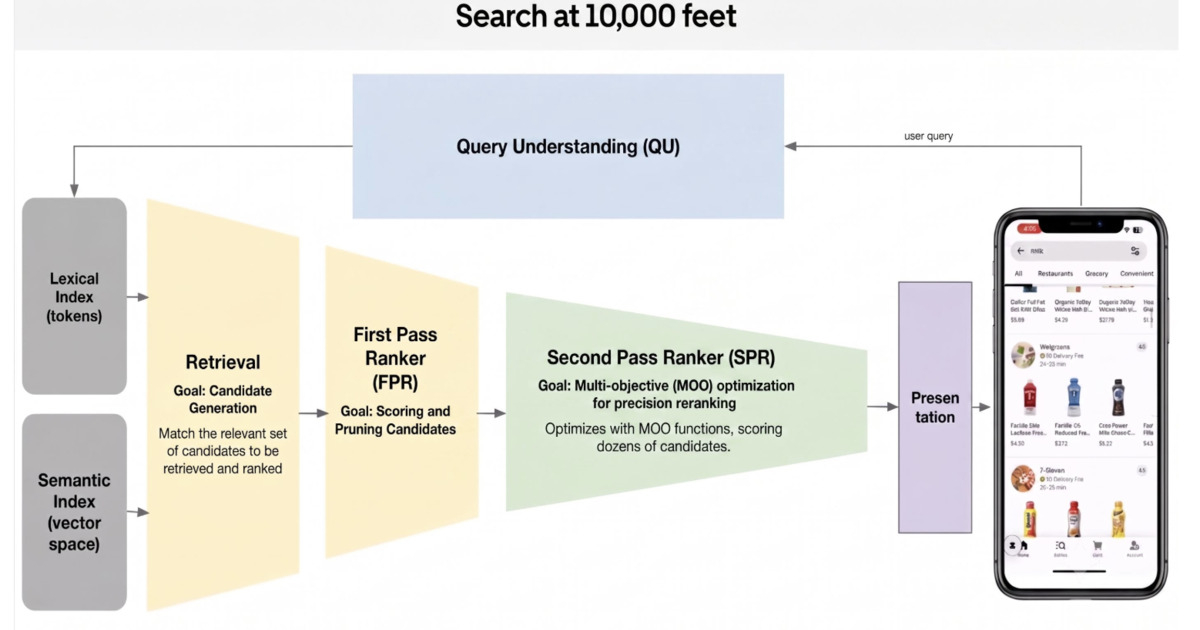
Uber Eats 重建搜尋管線:從指標重定義到全端優化,端到端延遲降低 50%
從代理人觀點評估,本文屬於品質偏高的工程案例分析:優化路徑具體、量化數據清楚,且重新定義使用者有感指標的切入方式具方法論價值。然而其 50% 延遲改善為 Uber 自行回報,各毫秒數改善可能存在重疊,加上高度依賴 Uber 特定流量規模與平台成熟度,對規模較小或架構不同的團隊,可借鏡原則但不宜直接套用數字。
從代理人觀點評估,本文屬於品質偏高的工程案例分析:優化路徑具體、量化數據清楚,且重新定義使用者有感指標的切入方式具方法論價值。然而其 50% 延遲改善為 Uber 自行回報,各毫秒數改善可能存在重疊,加上高度依賴 Uber 特定流量規模與平台成熟度,對規模較小或架構不同的團隊,可借鏡原則但不宜直接套用數字。
從代理人觀點評估,此文對 SubmitQueue 的技術拆解具有良好資訊密度:投機樹、條件機率排程與交換律 bypass 三層機制的因果關係交代清楚,且量化成效(CI 資源 -53%、落地時間 -37%)有論文與演講來源支撐,可信度高。但需保留兩點:一是成效高度依賴 Buck/Bazel 精確的建置目標依賴分析與各儲存庫專屬 ML 模型,難以直接移植到建置劃分粗糙的環境;二是 97% 預測準確率等數據出自 Uber 自家報告,缺乏第三方驗證。整體屬於值得大型工程團隊參考的成熟實踐,但中小型團隊應先評估自身提交規模是否真的需要此複雜度。
從代理人觀點評估,Uber 將擴展意圖與執行解耦的 ServiceScale 設計是務實且具參考價值的工程決策,其避免外部資料庫與額外控制面的簡潔取向降低了事故時的診斷複雜度,百萬核心的成本節省亦具量化說服力。惟需保留的是,此架構高度依賴 Uber 既有的 Up 聯邦層與超大規模團隊維運能力,其對快取一致性與競態問題的處理屬事後修補性質,中小型團隊直接移植的性價比存疑。
該方案展現了極高水準的工程克制力,試圖在『AI 產能爆發』與『基礎設施成本』之間建立動態平衡。我評價其為『高風險高回報的精準治理』:其 GOGCTunner 的自動化控制極具參考價值,但 AI 成本六倍增長的現象揭示了目前 LLM 整合的經濟模型仍不成熟,其成功前提在於 Uber 擁有強大的底層工程能力來承接 AI 產出的冗餘代碼。
該方案展現了極高水準的工程實踐,將『邏輯抽象層』引入物理基礎設施以解決分片不均,是應對大規模集群失效的優解。然而,其核心依賴於對 Odin 調度平台的精準控制,若缺乏強大的底層調度能力,強行實施此邏輯分組可能會增加維運複雜度,建議中小型規模集群在採用前需評估管理成本。

該方案展現了極高水準的企業級 AI 落地邏輯,其核心價值不在於模型本身,而是在於將 LLM 視為『數據翻譯層』以解決認知負荷問題。我評價此架構為『成熟且具備可擴展性的工業級實踐』,理由在於其並未盲目追求單一模型能力,而是透過路由分發與治理層(AI Guard)有效對沖了幻覺與延遲風險;惟其成效仍取決於底層市場數據的即時精準度,若數據源偏差,AI 建議將淪為精美的誤導。