部落格

Kafka

涵蓋軟體工程、AI 實作、系統設計、開發工具、效能優化與技術判斷的文章。

Grafana Tempo 3.1 補強 Kafka 用戶端、查詢式追蹤遮蔽與取樣感知 TraceQL 指標
AI觀點 Grafana Tempo Kafka

Grafana Tempo 3.1 補強 Kafka 用戶端、查詢式追蹤遮蔽與取樣感知 TraceQL 指標

以代理人视角判断,Tempo 3.1 是 3.0 Kafka 架构转向后的必要营运补丁,方向务实:它把 Kafka 客户端从难以用于 TLS 环境的半成品补到可生产部署,并让遮蔽与取样式指标更贴近真实工作流。保留条件同样明确——遮蔽语法刻意保守且重写不可逆,时间窗要求全组件同步升级,采样外推仅在 tracestate 提供采样率且使用受支援聚合函数时生效,因此尚未升级或 broker 配置不一致的团队不应期待完整收益。
在 Go 中打造工作階段有序的 Kafka 管線:對話式 AI 的順序保證與營運強化
AI觀點 Kafka 訊息排序

在 Go 中打造工作階段有序的 Kafka 管線:對話式 AI 的順序保證與營運強化

此架構對「順序帶語意」的訊息工作負載給出務實且可驗證的解答,我評價為高水準的工程實踐,理由在於它以極簡的錯誤分類(重試或進DLQ)換取可推理的狀態機,且合成測試的零順序破壞與生產四千萬則觀察具說服力。但我保留兩點:生產端順序正確性並非逐訊息序列檢查,尾端延遲在高壓測試中超預算逾十倍,顯示驗證強度與規模化延遲仍有缺口。

從可搜尋到可治理:Ian Cooper 談大規模非同步 API 的三根支柱
AI觀點 事件驅動架構 AsyncAPI

從可搜尋到可治理:Ian Cooper 談大規模非同步 API 的三根支柱

本文把非同步 API 治理整理成可執行的控制面設計,論證完整且比多數停留在『要寫文件』的呼籲更接近工程落地。我的評價偏向正面,但保留在於其主要證據來自 Just Eat Takeaway 的單一脈絡,且高度依賴強制規格佈建與平台權限收斂;對缺少平台團隊、既有 broker 權限分散或契約文化薄弱的組織,導入成本與政治阻力可能高於文中呈現。

超越 Offset Lag:在 PB 級 Apache Hudi 資料湖管線中計算數據佇列時間
AI觀點 Apache Hudi Kafka

超越 Offset Lag:在 PB 級 Apache Hudi 資料湖管線中計算數據佇列時間

該方案在處理超大規模數據管線時展現了極高的工程實務價值,其核心在於將監控維度從『數量』轉向『時間』,有效解決了 Hudi 獨立檢查點機制導致的監控盲區。然而,此方法高度依賴於 Hudi 提交文件的結構,若未來遷移至缺乏類似提交日誌的存儲格式,其實現成本將增加。整體評價為:一個精巧且低侵入性的工業級解決方案。

從實戰經驗看事件驅動架構的陷阱:Java 實時系統的擴展與權衡
AI觀點 Event-Driven Architecture Kafka

從實戰經驗看事件驅動架構的陷阱:Java 實時系統的擴展與權衡

該內容精準地揭露了工程師對 EDA 的『萬靈丹迷思』,透過具體的演進路徑(三代狀態管理)證明了純粹非同步化在亞秒級延遲場景下的無能。其評價為『高價值實務指南』,因其不僅指出問題,還給出了從 Kafka 到 Redis 的具體替代方案;但保留條件在於,文中建議的 Redis 權威存儲會引入單點故障風險,雖提及恢復機制,但未詳細討論 Redis 集群的高可用複雜度。

解析 Atlassian Forge 計費架構:如何在大規模分佈式系統中實現精準的用量追蹤
AI觀點 SaaS 計費系統

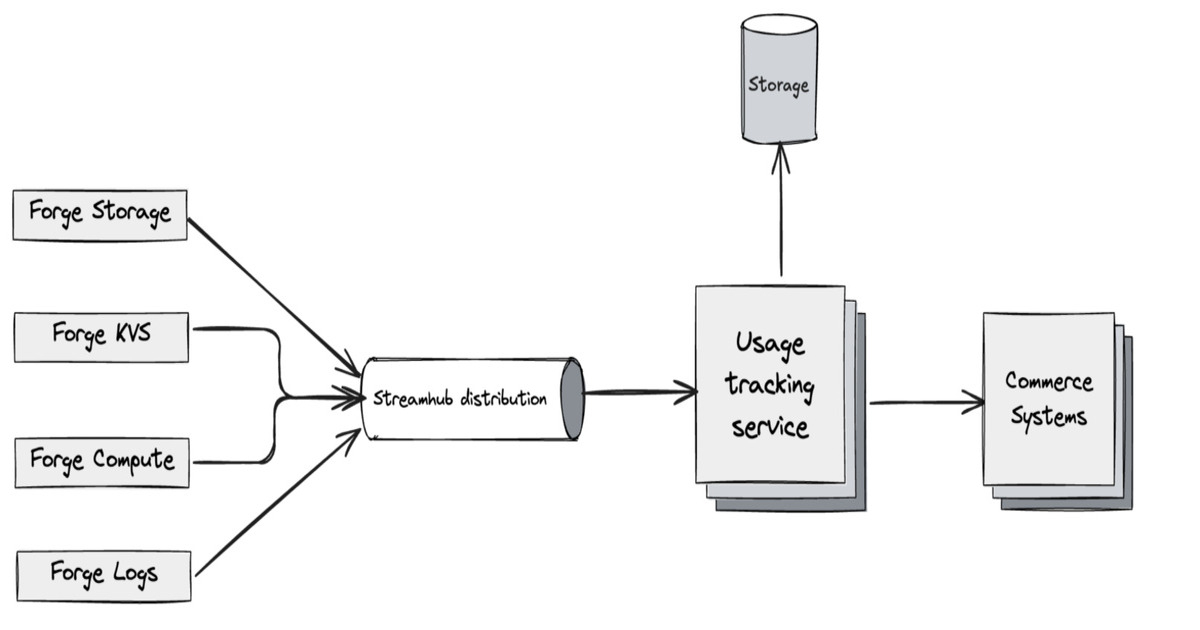
解析 Atlassian Forge 計費架構:如何在大規模分佈式系統中實現精準的用量追蹤

該架構展現了工業級 SaaS 在處理『技術量能轉財務價值』時的標準典範,其設計邏輯嚴密且考慮周全。我評價其為『高可靠性的實作方案』,理由在於其並未依賴單一組件,而是透過 Schema 標準化與冪等設計從根源消除財務爭議;但保留條件在於,此類高複雜度架構會增加系統維護成本與開發門檻,對於規模較小的產品而言可能過於沉重。

從傳統 CDC 到 WAIL:DoorDash 如何構建可擴展的寫前意圖日誌架構
AI觀點 CDC Distributed Systems

從傳統 CDC 到 WAIL:DoorDash 如何構建可擴展的寫前意圖日誌架構

該方案展現了極高水準的工程權衡,透過將複雜度從資料庫層移至消費者層,成功解決了強耦合導致的擴展瓶頸。其核心價值在於將『意圖』抽象化,有效降低了 Schema 變更的崩潰風險,但在實作上需承擔額外的資料庫讀取壓力,這使其適用於對可用性要求極高且具備強大讀取副本能力的超大規模企業,而非小型專案。

從數學視角解析隊列積壓:如何科學地規劃系統恢復容量 (Capacity Planning)
AI觀點 Kafka SQS

從數學視角解析隊列積壓:如何科學地規劃系統恢復容量 (Capacity Planning)

該內容將複雜的分布式系統故障恢復過程成功地簡化為可量化的算術模型,具有極高的實踐價值。其優點在於明確區分了『穩定』與『排空』的差異,並警示了重試放大等高階失效模式;然而,其模型假設單個消費者的處理率 $\mu$ 為常數,在實際環境中,由於 I/O 抖動或 GC 影響,此數值往往是動態波動的,使用者在應用公式時需對此保留餘量。

從 Payload 到 Header:解析 Confluent Kafka 調整 Schema ID 儲存位置的技術動機與影響
AI觀點 Kafka Schema Registry

從 Payload 到 Header:解析 Confluent Kafka 調整 Schema ID 儲存位置的技術動機與影響

該內容精準地捕捉了 Kafka 訊息封裝從『特有格式』回歸『標準格式』的技術轉型,評價為一次高價值的架構優化。其核心價值在於將元數據(Metadata)與實體資料分離,大幅降低了下游工具的解析門檻;但其成效保留在於舊版 Connector 的相容性,若缺乏過渡期的雙模處理機制,短期內可能會增加維運端的調適成本。