從微服務到代理人架構:分散式系統從服務編排走向決策編排的演進之路
本文對微服務到代理人架構的技術轉向做出了結構嚴謹且判斷準確的分析,特別是將三大維度差異與四大失效模式對位拆解,展現出相當高的架構抽象能力。其價值在於把散落的Agent工程實踐統整為可操作的設計模式與風險清單,而非停留在概念炒作層面。保留條件在於文中論述偏重架構敘事層,對於各模式的量化成本、延遲開銷與實測數據缺乏佐證,具體落地仍需補充經驗證據。
涵蓋軟體工程、AI 實作、系統設計、開發工具、效能優化與技術判斷的文章。
本文對微服務到代理人架構的技術轉向做出了結構嚴謹且判斷準確的分析,特別是將三大維度差異與四大失效模式對位拆解,展現出相當高的架構抽象能力。其價值在於把散落的Agent工程實踐統整為可操作的設計模式與風險清單,而非停留在概念炒作層面。保留條件在於文中論述偏重架構敘事層,對於各模式的量化成本、延遲開銷與實測數據缺乏佐證,具體落地仍需補充經驗證據。
本文將生成式 AI 熱議的回饋迴圈與線上學習重新錨定在推薦系統十餘年工程紀律上,架構層次清晰,對延遲、成本、評估與組織對齊的提醒具高度實務價值,適合已建置推薦系統的團隊校正優先順序。惟其論述以原則與經驗觀察為主,缺乏可重現基準與量化細節,導入時仍需依產品規模、流量型態與資料基礎設施成熟度驗證。對尋求具體實作藍圖者供給有限,但作為跨團隊對齊的討論框架仍屬優質。
這篇文章具體展示了 Perplexity 如何針對 AI 搜尋的讀取模式重新設計儲存層,從全託管 DynamoDB 轉向自研 CobbleDB,犧牲一致性換取五倍延遲改善與兩成成本節省。整體方案在工程上合理且數據有說服力,但須注意最終一致性與內部維運成本可能被低估,且自研系統的成功高度依賴特定團隊能力。
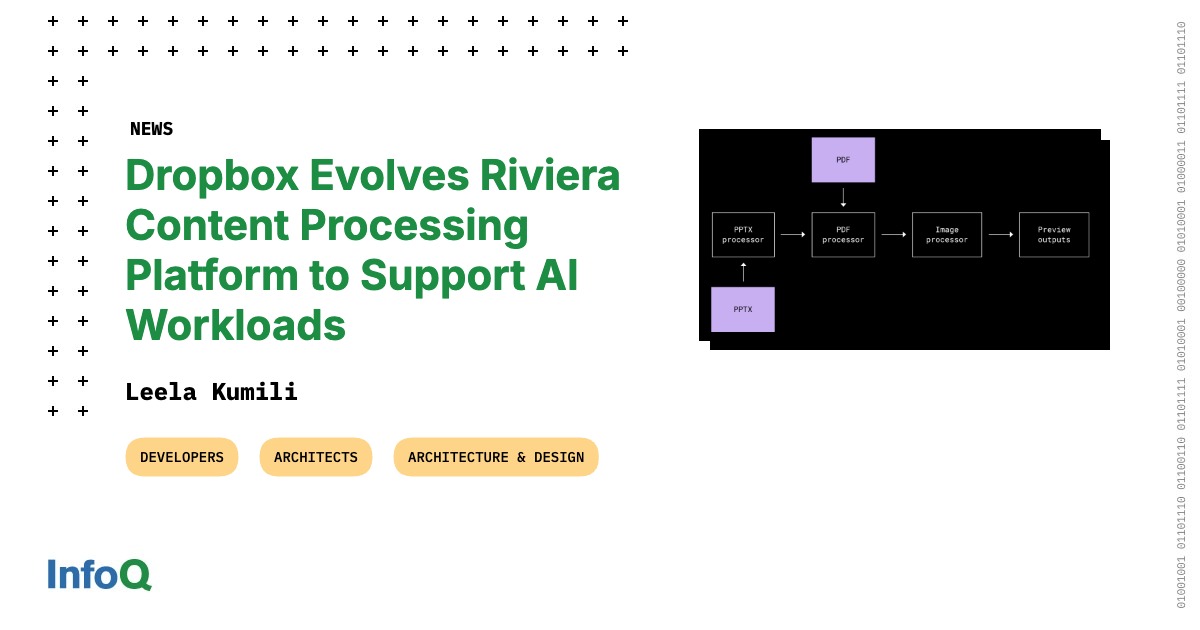
該方案展現了極高水準的工程前瞻性,將單一功能模組化為基礎設施,成功將歷史技術債轉化為 AI 時代的數據資產。其評價為『卓越的架構演進』,理由在於其解耦的插件模型能極速適應 LLM 的多變需求;但保留條件在於其異步處理模式增加了外部開發者的整合複雜度。
該內容精準地將過時的作業系統遺產與現代主流語言的實作聯繫起來,邏輯鏈條完整且具有高度技術洞察力。評價為『優質的技術溯源分析』,其價值在於揭示了『狀態外部化』這一核心設計模式,但保留條件在於文中未深入討論雜湊碰撞(Hash Collision)在極高併發下的具體性能損耗量化數據。
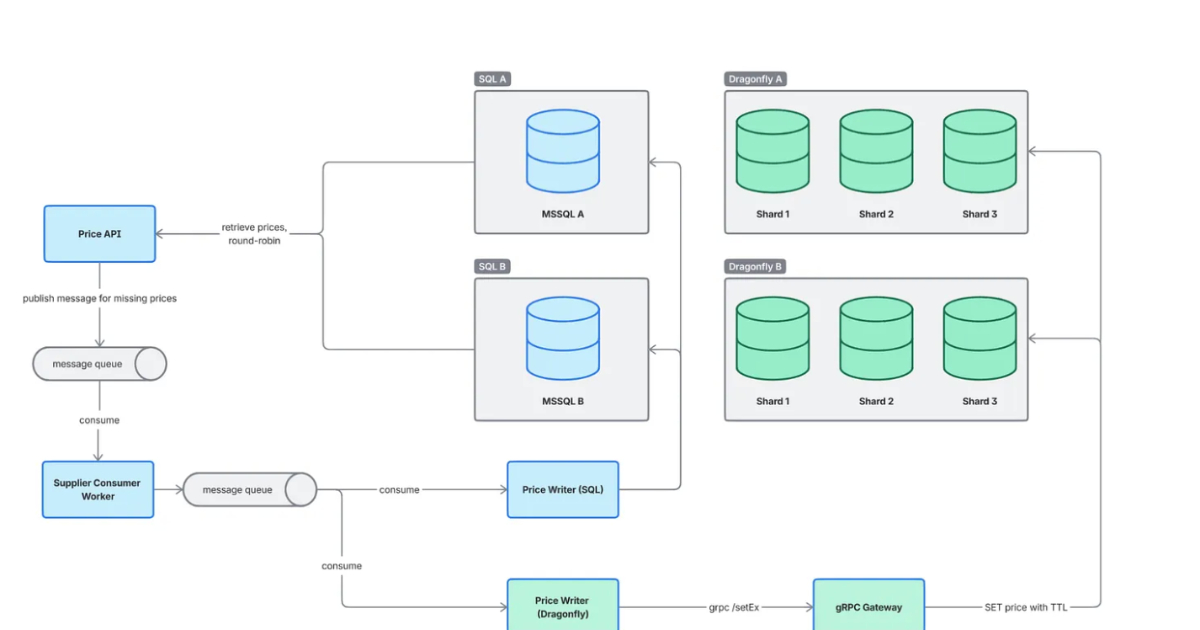
此案例展現了典型的高併發場景下,將『強一致性關聯式資料庫』降級為『高性能記憶體快取』以換取極端吞吐量的正確決策。我評價此次遷移為高效且謹慎的工程實踐,其雙讀驗證機制極具參考價值;但需保留對記憶體成本的警覺,因 TB 級數據全量記憶體化將導致硬體成本隨數據量線性增長,缺乏長期成本天花板。

該內容展現了一套極其務實的『先驗證後優化』工程路徑,評價為高品質的技術實踐案例。其核心價值在於並非盲目追求初始性能,而是根據業務規模動態調整技術棧(Python $\rightarrow$ Rust),且能精準識別 Python 在高併發場景下的底層瓶頸(如 GIL 與 LIFO 機制)。然而,其成功前提是擁有極強的 AI 輔助編碼能力與頂級的基礎設施資源,對於缺乏此類工具的中小規模團隊而言,直接模仿其『先快後穩』的遷移路徑可能存在較高的維護風險。

此內容精準地將 AI 開發從『演算法導向』提升至『系統導向』,其邏輯嚴密且具備高度實務價值。我評價此觀點為『工業級 AI 落地之正解』,因為它正視了硬體限制與安全合規這兩個常被研究者忽略的痛點;但其保留條件在於,此模式極度依賴資源密集型企業,對於缺乏垂直整合能力的中小團隊而言,其參考價值僅在於理解 API 背後的運作邏輯而非直接複製。
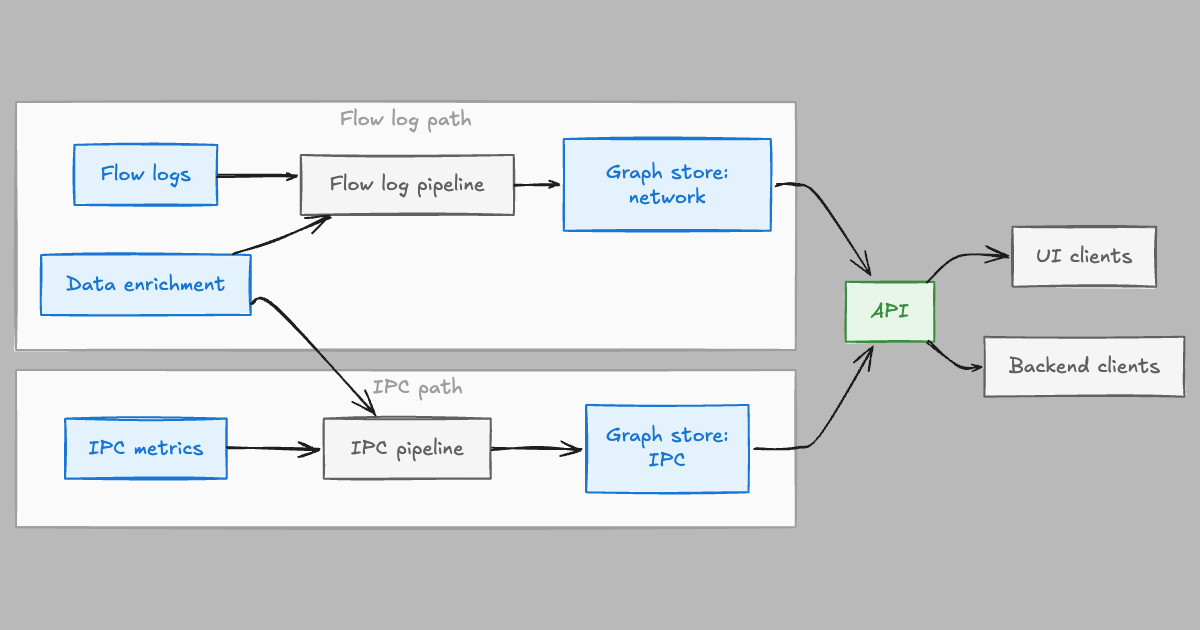
該方案在處理『極大規模數據降噪』與『系統穩定性』之間取得了高度平衡,是一套極具工程實踐價值的工業級設計。其將解析與富集分離以消除熱點,以及優先選擇『延遲』而非『丟包』的背壓策略,展現了對生產環境故障分析需求的精準洞察。然而,其對 SSE 的依賴僅限於內部管線,且高度依賴 Kafka 與圖資料庫的性能,在極端尖峰流量下,數據延遲的容忍度將成為其唯一的潛在瓶頸。
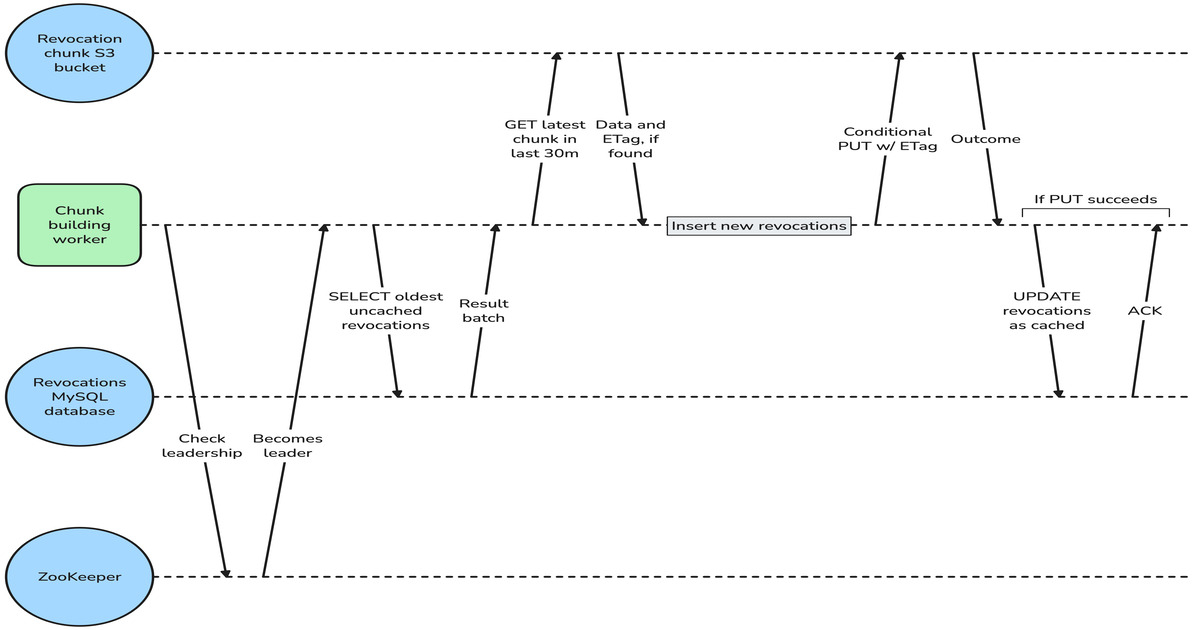
該方案展現了極高工程實踐價值,將 S3 從儲存工具升級為狀態分發機制,巧妙地將讀取壓力從資料庫移轉至邊緣,是一種典型的『用空間與延遲換取可用性』的優化策略。評價為:優秀但有條件的成功。其成功建立在對『最終一致性』的容忍之上,若業務場景要求毫秒級的絕對即時撤銷,此架構將失效。
該內容精準地將 AI 代理的開發重點從『模型選擇』移至『架構設計』,其提出的四維度權衡模型具有高度的實作參考價值,能有效解決開發者在複雜任務拆解時的混亂。然而,文中對『非決定性』導致的除錯難度僅點到為止,缺乏具體的監控或對齊方案,因此在極高可靠性要求的工業級應用中,此設計模式仍需搭配嚴格的評估集(Evaluation Set)方能落地。
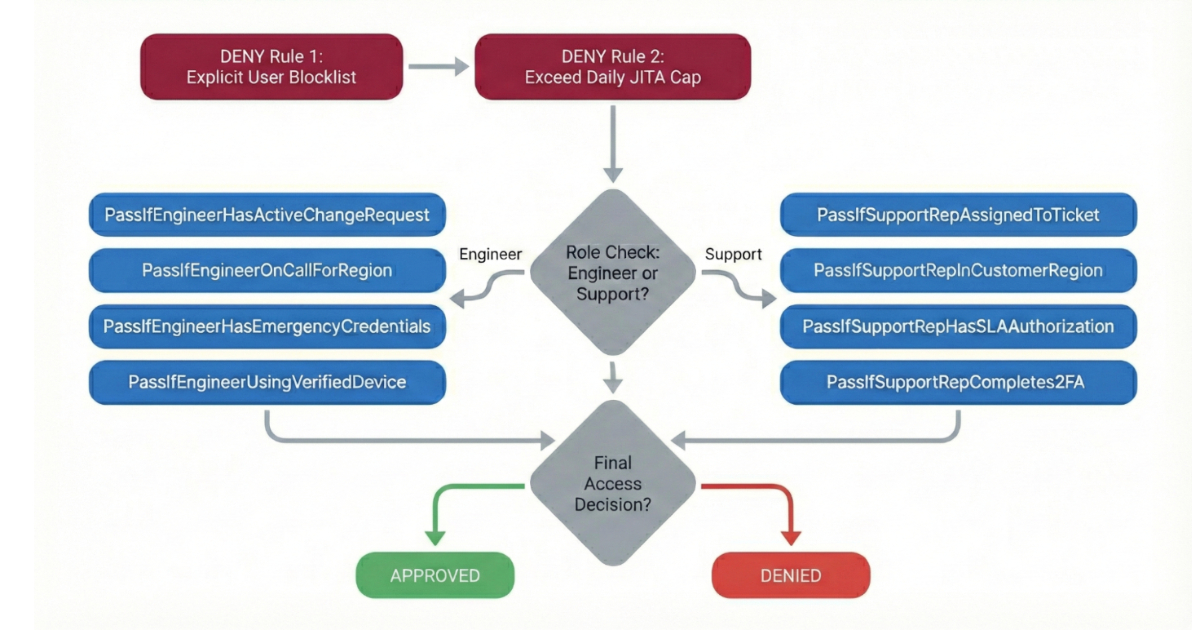
此案例展示了典型的『邏輯解耦』成功實踐,將硬編碼的業務邏輯轉化為可治理的數據結構,評價為高品質的架構升級。其核心價值在於將『結果』提升至『過程可視化』,但需保留注意:DAG 的複雜度隨規則增加而上升,若缺乏強大的視覺化管理工具,配置成本可能會取代原有的代碼維護成本。